Relacja: MARGO na ACCU on Sea 2026
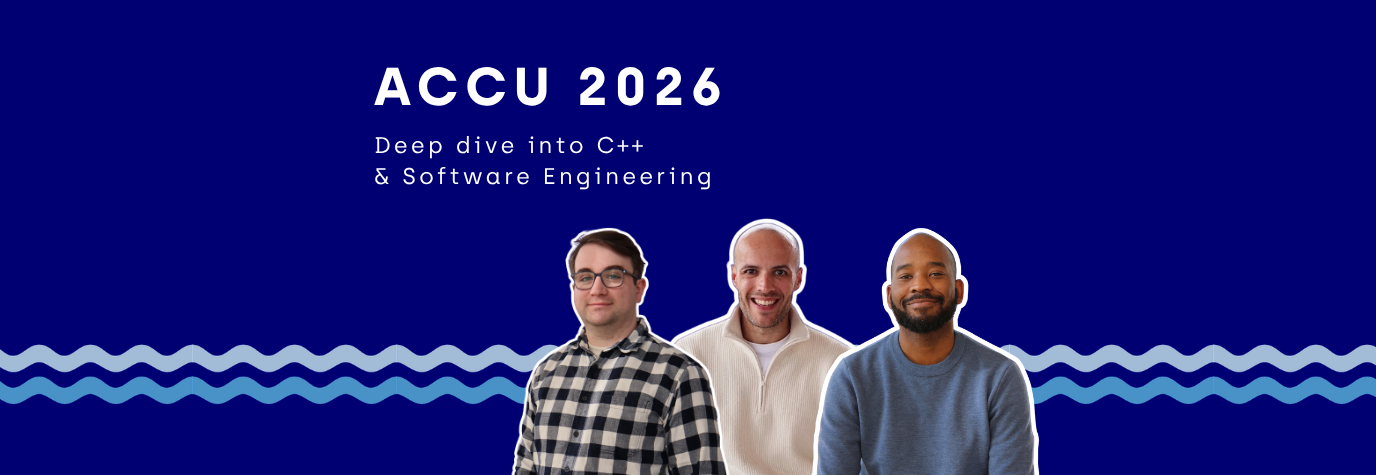
W czerwcu trzech naszych ekspertów wzięło udział w ACCU on Sea 2026. Ta międzynarodowa konferencja to jedno z najważniejszych wydarzeń społeczności C++. Spotykają się na niej inżynierowie systemowi, programiści i członkowie komitetu standaryzacyjnego, by rozmawiać o kierunkach rozwoju naszej dziedziny.
Przez cztery dni Prosper Gratian, Thibault Ricord-Marchal i Paul Chaucheprat uczestniczyli w intensywnym programie wystąpień poświęconych nowoczesnemu C++, wydajności w czasie rzeczywistym i architekturom systemowym. To zanurzenie w złożonych tematach wpisuje się w działania naszego Ośrodka Doskonałości, którego celem jest utrzymanie naszych praktyk w czołówce inżynierii oprogramowania.
Wierni naszej kulturze dzielenia się wiedzą, po powrocie do Francji trzej konsultanci zebrali i uporządkowali swoje notatki. Cel tego obszernego podsumowania doświadczeń (REX) jest dwojaki: od razu wzbogacić nasze metodyki projektowe i przekazać całą tę wiedzę naszym zespołom podczas specjalnego MARGO Learning Lunch (LLM), a także na jednym z kolejnych meetupów.
Ten artykuł to pełne i szczegółowe podsumowanie techniczne najważniejszych sesji konferencji. Od keynote’u Andrieja Alexandrescu po szczegółowe analizy mikroarchitektury i wzorca Sender/Receiver: oto co warto wynieść z ACCU 2026.
Temat 1: współbieżność strukturalna i nowoczesna asynchroniczność na ACCU on Sea
Jednym z głównych tematów tegorocznej edycji ACCU była formalizacja współbieżności strukturalnej (structured concurrency) i zapowiedziany koniec starszych modeli asynchronicznych. Asynchroniczność w C++ ma złożoną historię, naznaczoną abstrakcjami często nieefektywnymi lub podatnymi na błędy. Poświęcone jej sesje pozwoliły podsumować tę historię i lepiej zrozumieć przełom, jaki przynosi wzorzec Sender/Receiver planowany w C++26.
„Cmentarzysko” starszych wzorców asynchronicznych
Sesja Roberta Leahy’ego (The Async Pattern Graveyard) uwypukliła wady architektoniczne podejść historycznych:
- Podejścia odziedziczone po C: funkcje takie jak
getaddrinfo(w porównaniu z alternatywami, takimi jakares_getaddrinfo) z natury cierpią na brak współbieżności strukturalnej i zbyt sztywne profile blokowania. - Natywne abstrakcje STL: klasyczne użycie
std::futureistd::asyncuchodzi dziś za przestarzałe (materiał na cmentarzysko). Te modele cierpią na niejawne i systematyczne alokacje na stercie, brak natywnego zarządzania zależnościami między zadaniami i sztywny model wykonania. - Porównanie z Boost.Asio: choć Boost.Asio jest szeroko stosowany w produkcji, model raw callbacks pozostaje trudny w utrzymaniu i szczególnie podatny na błędy w porównaniu z nowymi standardami opartymi na RAII.
Nadejście std::execution (Sender/Receiver)
Nowoczesny paradygmat opiera się obecnie na wzorcu Sender/Receiver zdefiniowanym w std::execution. Jego podstawową zasadą jest całkowite oddzielenie definicji pracy od faktycznego kontekstu jej wykonania (wątku lub puli wątków, które ją wykonają).
Dzięki wyeliminowaniu zbędnych alokacji pamięci na stercie ten framework zapewnia bardzo wydajną strukturę dla środowisk wielowątkowych i wysokowydajnych asynchronicznych operacji wejścia/wyjścia (I/O).
Wnioski: od live codingu do produkcji
Dwie kluczowe sesje pozwoliły skonfrontować te ramy teoretyczne z praktyką:
- Praktyczna implementacja (Dietmar Kühl): na przykładzie live codingu asynchronicznego interfejsu sieciowego komunikującego się z bazą PostgreSQL Dietmar Kühl zaprezentował kompletny, rzeczywisty przypadek użycia nowego frameworka. Ćwiczenie pokazało jednak obecną złożoność implementacji i wywołało liczne dyskusje na temat ilości kodu boilerplate potrzebnego do napisania własnego Sendera. Projekt sendera okazuje się silnie zorientowany na użytkownika, ponieważ bezpośrednio kształtuje sposób pisania zależnego od niego algorytmu.
- Refaktoryzacja i lokalność algorytmiczna (Roi Barkan): sesja Refactoring Towards Structured Concurrency pokazała przejście od starszych architektur do współbieżności strukturalnej. Główna zaleta to łatwość wstrzykiwania zależności do zadań asynchronicznych i ścisła zgodność z zasadą RAII. Ten wzorzec zapewnia lepszą lokalność naszych algorytmów wielowątkowych, co znacznie ułatwia rozumowanie o kodzie i ogólne projektowanie systemów współbieżnych.
Na co uważać: wpływ na wydajność
Mimo dużych postępów w projektowaniu wydajność pozostaje obecnie krytycznym punktem wzorca Sender/Receiver. Na tym etapie potrzebne są jeszcze wysiłki:
- Po stronie kompilatorów: w zakresie optymalizacji kodu generowanego dla różnych scenariuszy senderów.
- Po stronie schedulerów: w zakresie pisania dostosowanych i zoptymalizowanych schedulerów, aby w pełni wykorzystać realny zysk wydajności w porównaniu z istniejącymi rozwiązaniami.
Temat 2: metaprogramowanie i C++26 w pigułce
Wprowadzenie ustandaryzowanej refleksji to jeden z najbardziej wyczekiwanych i najpotężniejszych projektów nadchodzących standardów C++. Rozmowy na ACCU 2026 pozwoliły nakreślić jasny obraz: choć te funkcje dają bezprecedensowe możliwości abstrakcji, ich wdrożenie w produkcji wymaga najwyższej czujności wobec realiów kompilatorów.
Perspektywa makro: specjalizacja i abstrakcje, które da się wyrazić
Otwierający keynote Andrieja Alexandrescu (The Next 20 Weeks of Systems Engineering) wyznaczył makroekonomiczne i techniczne ramy tych zmian. Jego zdaniem wpływ AI nieuchronnie popycha w stronę specjalizacji ekspertyzy, ponieważ ogólną pracę na powierzchownych warstwach można dziś łatwo zautomatyzować. Aby bazy kodu mogły przetrwać, systemy muszą same wyrażać swoje zamiary poprzez jasne i wspólne abstrakcje. Właśnie tu wkraczają nowe funkcje języka:
- Kontrakty: by jasno określić warunki użycia.
- Refleksja: by abstrahować i rozumować o samym kodzie.
- Utwardzanie STL: by zabezpieczyć programy przez eliminację zachowań niezdefiniowanych (Undefined Behaviors).
Budowanie mostów: od refleksji w czasie kompilacji do refleksji w czasie wykonania
Z definicji natywna refleksja w C++26 działa wyłącznie w czasie kompilacji. Tymczasem praktyczna inżynieria oprogramowania (serializacja gRPC, dynamiczne mapowanie obiektów, wiązania UI) często wymaga elastyczności w czasie wykonania.
Prezentacja Laurie Kirk przedstawiła CMM (Call Me Maybe), bibliotekę zaprojektowaną, by zbudować most między tymi dwoma światami. CMM mierzy się z wyzwaniem przekształcania wartości consteval w wartości statyczne w czasie wykonania. Jej siłą jest całkowita niezależność od RTTI (Run-Time Type Information). Dzięki lekkim adnotacjom i nowym funkcjom C++26 – zwłaszcza define_static_objects i blokom consteval – CMM umożliwia refleksję w czasie wykonania, która przewyższa starsze biblioteki, a jednocześnie minimalizuje wpływ na rozmiar pliku binarnego (binary bloat).
Z kolei sesja Hany Dusíkovej (Where does constexpr start and where it ends) podsumowała obecny stan obliczeń w czasie kompilacji. Pokazała, jak kompilator zachowuje się niczym prawdziwy interpreter C++, wykonując kod na etapie kompilacji. Hana zilustrowała siłę tego paradygmatu na przykładzie swojej ulubionej struktury danych: hashed Array Mapped Trie (HAMT), która gwarantuje wysoką wydajność wyszukiwania, wstawiania i usuwania.
Realia kompilatorów: koszmar IFNDR
Mimo powszechnego entuzjazmu sesja Dana Katza (Portable Reflection in C++26) sprowadziła programistów na ziemię, do realiów implementacji przemysłowych. Przekaz jest kluczowy: zatwierdzony standard nie gwarantuje jednolitej implementacji u wszystkich dostawców kompilatorów.
Główny punkt tarcia polega na tym, że GCC i Clang rozwiązują szablony w zupełnie innych momentach kompilacji jednostki translacji. Ta rozbieżność czasowa otwiera drogę do błędów typu IFNDR (Ill-Formed No Diagnostic Required) – to koszmarny scenariusz dla autorów bibliotek: kod refleksji może bezproblemowo kompilować się w GCC, a w Clangu zawieść katastrofalnie lub wygenerować zachowanie niezdefiniowane, i to bez najmniejszego ostrzeżenia podczas kompilacji.
Aby projektować lub wdrażać przyszłe biblioteki refleksji C++26, trzeba od pierwszego dnia uwzględniać IFNDR, mnożyć testy na wielu kompilatorach i precyzyjnie kontrolować moment instancjacji szablonów.
Temat 3: mikroarchitektura, modele pamięci i sprzęt
Optymalizacja wydajności w C++ nie jest możliwa bez dogłębnego zrozumienia mikroarchitektury procesora. Na tym poziomie inżynierii teoretyczna złożoność algorytmiczna często ustępuje fizycznej rzeczywistości zarządzania pamięcią podręczną i wykonywania instrukcji przez CPU.
Potok CPU i wykonanie poza kolejnością (OoOE)
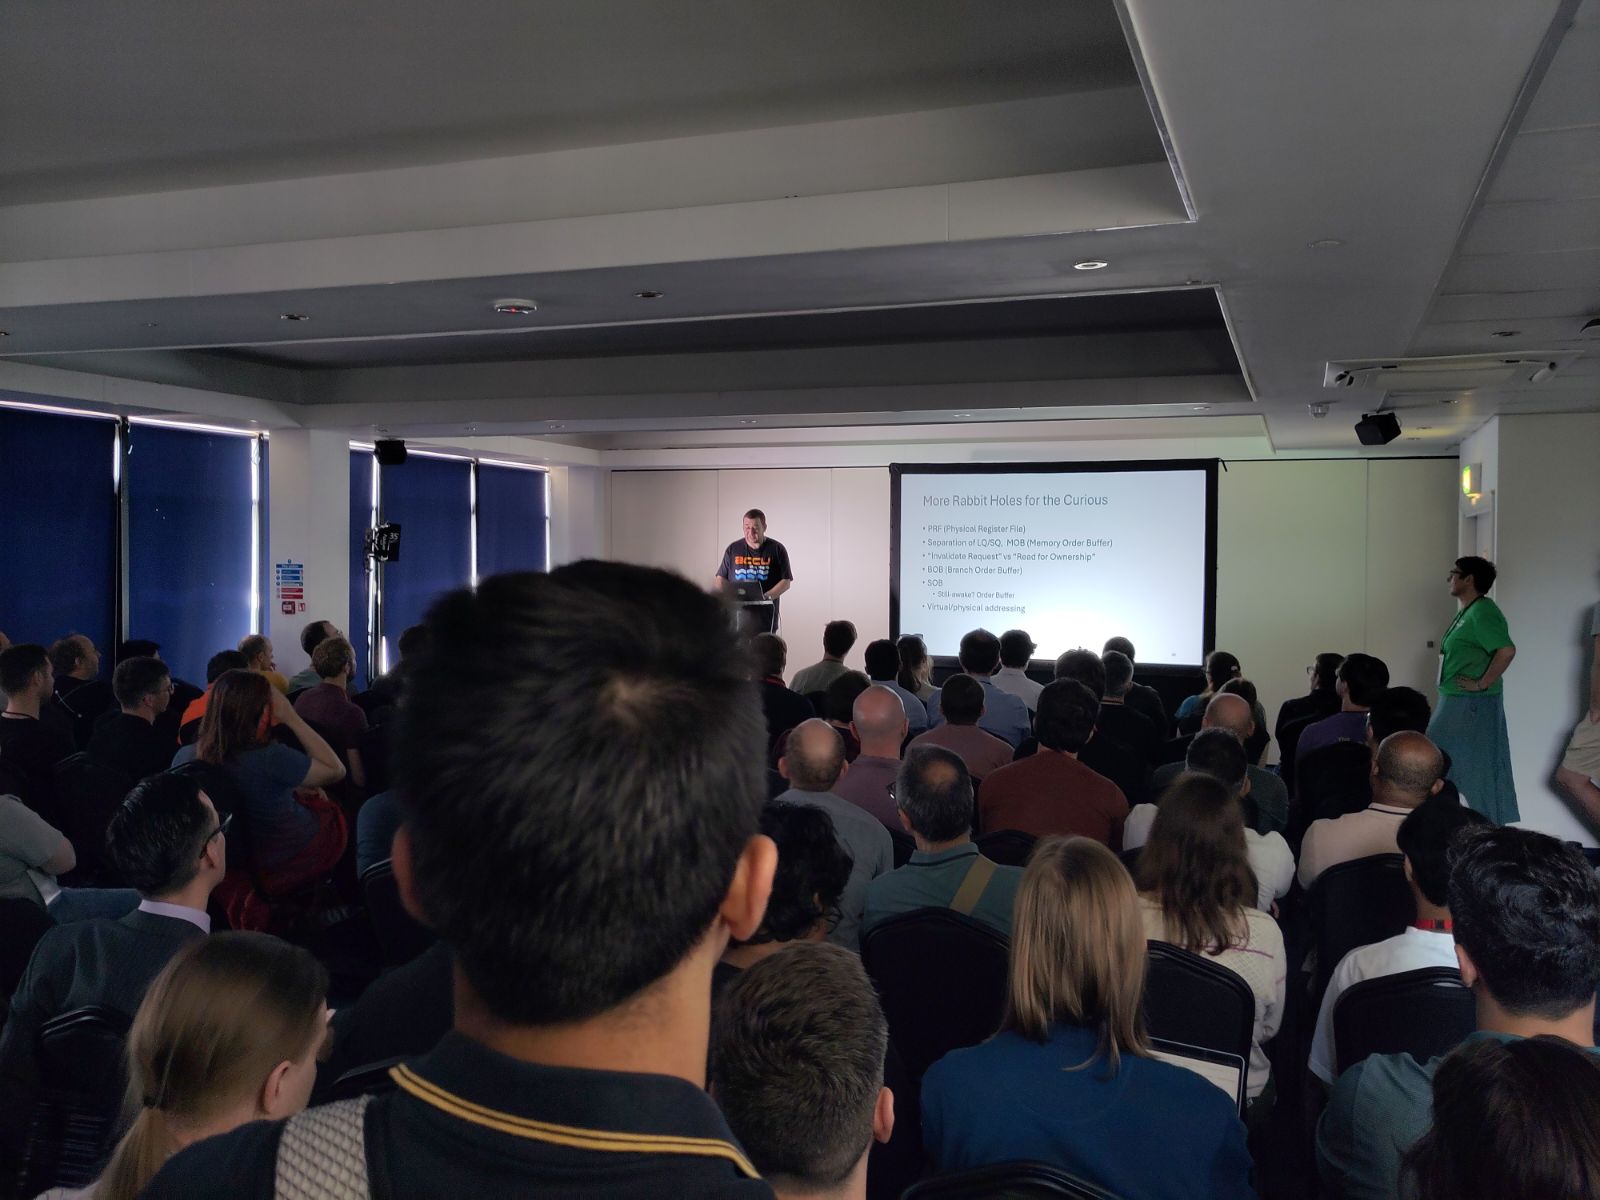
Sesja Ofeka Shilona (Processor Design and Memory Models) szczegółowo pokazała, jak nowoczesne procesory wykonują instrukcje i utrzymują aktualny obraz zawartości swoich pamięci podręcznych. Aby zmaksymalizować wydajność, CPU wykonują instrukcje w kolejności innej niż w kodzie źródłowym (Out-of-Order Execution) dzięki wyspecjalizowanym komponentom sprzętowym:
- Register Alias Table (RAT): zarządza przemianowywaniem rejestrów, aby eliminować fałszywe zależności danych.
- Reorder Buffer (ROB): gwarantuje, że mimo wykonania poza kolejnością instrukcje są zatwierdzane i stosowane w prawidłowej, pierwotnej kolejności.
Ta wyrafinowana mechanika wiąże się jednak ze ścisłymi ograniczeniami przy operacjach atomowych lub kodzie wielowątkowym. Potoki CPU i dokładne momenty, w których wchodzą do gry instrukcje atomowe, decydują o wydajności programu. Niewłaściwe użycie operacji atomowych może zablokować te mechanizmy sprzętowe i spowodować znaczne spadki wydajności.
Przewidywanie rozgałęzień i zarządzanie pamięcią podręczną
Matt Godbolt w sesji Microarchitecture: What Lies Beneath poszedł jeszcze dalej w inżynierii wstecznej firmware’u CPU, by zrozumieć wykorzystanie wewnętrznych tablic i pamięci podręcznej.
Jedna z głównych lekcji dotyczy krytycznego kosztu związanego z przewidywaniem rozgałęzień. Zakłócenie przewidywania rozgałęzień, a tym bardziej jego całkowite unieważnienie, niszczy wydajność. Na przykład zjawisko False Sharing zmusza CPU do unieważnienia wszystkiego, co trzyma w pamięci podręcznej, aby zsynchronizować rdzenie, przez co cała korzyść z predykcji sprzętowych przepada.
Bezpośrednia rozmowa z Mattem Godboltem rzuciła też światło na optymalizację z użyciem PGO (Profile-Guided Optimization). Okazuje się, że skuteczne wdrożenie PGO w prostych kontekstach jest bardzo trudne. Nasze kompilatory i procesory stały się tak wydajne, że przypadek bazowy i naturalne przewidywanie rozgałęzień są często bliższe rzeczywistemu czasowi wykonania (runtime) niż to, co próbujemy przewidzieć za pomocą PGO. Aby PGO przyniosło realny zysk, masa wykonywanego kodu musi przekraczać to, co CPU jest w stanie utrzymać w pamięci podręcznej, a taki scenariusz trudno zaprojektować.
Prymitywy synchronizacji i modele pamięci
Aby rozwiązać niespójności pamięci podręcznej wynikające z wykonania spekulatywnego i wielowątkowości, Ofek Shilon przypomniał rolę prymitywów synchronizacji:
- Bariery pamięci (fences).
- Operacje load-acquire i store-release.
- Instrukcje read-modify-write.
W kategoriach czystej wydajności: jeśli kod nie respektuje wyrównania lub powoduje systemowe cache misses, najlepszy teoretyczny algorytm przegra z prostszym kodem, lepiej dopasowanym do sprzętu.
Temat 4: synteza naszych ekspertów na temat zarządzania kodem legacy
Ostatnia część ACCU 2026 dotyczyła granicy między obietnicami języka a rzeczywistością ich wykonania, a także narzędzi przemysłowych niezbędnych do rozwijania istniejącego kodu bez wprowadzania regresji.
Iluzja „Zero-Cost Abstractions”
Sesja Steve’a Sorkina (When Zero-Cost Abstractions Aren’t Zero-Cost) podważyła jedno z obiegowych przekonań w świecie C++. W teorii abstrakcja o zerowym koszcie nie powinna powodować żadnej utraty wydajności w czasie wykonania. W praktyce kompilator może mieć trudności z optymalizacją niektórych składni, choć są one bardzo czytelne, takich jak std::views czy zakresy (ranges) STL.
Steve Sorkin zilustrował ten problem, analizując wygenerowany kod asemblerowy. Na przykład łańcuch kilku filtrów przeplatanych transformacją (filter | transform | filter) mocno zaburza pracę optymalizatora. Zamiast scalić operacje, kompilator generuje kod, który przechodzi przez łańcuch wielokrotnie, co oznacza znaczny koszt maszynowy w porównaniu z klasyczną pętlą. Wniosek jest jasny: aby zweryfikować abstrakcję, analiza kodu asemblerowego i pomiary w praktyce pozostają niezbędne.
Niebezpieczeństwa optymalizacji i zachowania niezdefiniowane (UB)
Robert C. Seacord (członek komitetu C) pokazał, jak agresywne optymalizacje kompilatora mogą okazać się destrukcyjne, gdy zderzają się z zachowaniami niezdefiniowanymi.
Podręcznikowy przypadek dotyczył automatycznego usuwania sprawdzeń wskaźnika null. Jeśli wskaźnik jest dereferencjonowany na początku funkcji, kompilator zakłada, że jest on prawidłowy. W rezultacie po prostu usuwa wszystkie testy bezpieczeństwa if (ptr == nullptr) znajdujące się dalej w funkcji. Jeśli początkowa dereferencja nie spowoduje awarii programu, zabezpieczenie znika, otwierając drogę do poważnych luk bezpieczeństwa. Dokładnie taki błąd wystąpił w jądrze Linuksa. Zalecenie: systematycznie włączaj ostrzeżenia kompilatora.
Przemysłowa modernizacja kodu legacy: LLM kontra skrypty
Sesja Petera Muldoona (Modernizing Legacy Codebases without Stopping the World) przyniosła bardzo pragmatyczne spojrzenie na zarządzanie kodem legacy na dużą skalę. Modernizacji ogromnej bazy kodu nie da się przeprowadzić w magiczny sposób ani w pełni zautomatyzować za pomocą LLM czy wyłącznie narzędzia clang-tidy.
Skuteczne rozwiązanie polegało na połączeniu obu podejść. LLM posłużył do wygenerowania deterministycznych skryptów automatyzacji. Ta metoda ma kilka zalet:
- Niezawodność: uwalnia proces od niedeterministycznej natury i halucynacji modeli LLM.
- Audytowalność: skrypt to fragment kodu, o którym inżynier może rozumować, który może przetestować i zweryfikować na konkretnym przypadku.
- Industrializacja: skrypty pozwalają podzielić projekt na odrębne przeglądy kodu (PR/commity), co ułatwia wspólną pracę i śledzenie postępów projektu.
Obok tych metodyk sesja Tima Condona (Incrementally migrating C++ to a memory safe language) pokazała, że inne języki starają się budować solidne mosty z C++, by zapewnić lepszą interoperacyjność.
Fundamenty wobec przełomów jutra
ACCU on Sea 2026 było doskonałą migawką przyszłych kierunków rozwoju C++ i inżynierii systemowej. Bliskie nadejście przełomowych funkcji, takich jak model współbieżności std::execution (C++26) czy ustandaryzowana refleksja, pokazuje, że język ogromnie zyskuje na sile wyrazu i abstrakcjach. Wnioski naszych ekspertów wskazują jednak na kluczową rzeczywistość: margines błędu architektonicznego się kurczy.
Niezależnie od tego, czy chodzi o obchodzenie rozbieżności czasowych między kompilatorami (pułapka IFNDR), mierzenie rzeczywistego kosztu pozornie darmowych abstrakcji, czy codzienne radzenie sobie z fizycznymi ograniczeniami mikroarchitektur CPU (pamięci podręczne, OoOE, przewidywanie rozgałęzień), jedyną zasadą pozostaje opanowanie fundamentów sprzętowych i pomiary w praktyce. Techniczna hiperspecjalizacja nie jest już opcją: to niezbędny atut przy projektowaniu wydajnych, odpornych i trwałych systemów.
Porozmawiaj z ekspertem MARGODlaczego wzorzec Sender/Receiver (std::execution) zastąpi std::async i std::future?
Historyczne abstrakcje, takie jak std::future, cierpią na systematyczne niejawne alokacje na stercie, brak współbieżności strukturalnej i zbyt sztywne profile blokowania. Wzorzec Sender/Receiver w C++26 natywnie eliminuje te wady, całkowicie oddzielając definicję pracy od kontekstu jej wykonania. Zapewnia w ten sposób bardzo wydajny framework bez zbędnych alokacji pamięci dla wysokowydajnych środowisk wielowątkowych.
Na czym polega pułapka IFNDR związana z refleksją w C++26?
IFNDR (Ill-Formed No Diagnostic Required) to główny punkt, na który muszą uważać przyszłe biblioteki refleksji. Ponieważ GCC i Clang rozwiązują szablony w różnych momentach kompilacji, kod refleksji może bezproblemowo kompilować się w jednym z nich, a w drugim generować katastrofalne zachowanie niezdefiniowane, bez najmniejszego ostrzeżenia. Dokładna analiza momentu instancjacji szablonów (typy kompletne, typy zwracane) jest obowiązkowa od pierwszego dnia.
Dlaczego optymalizację PGO (Profile-Guided Optimization) trudno zastosować w prostych kontekstach?
Nowoczesne procesory i kompilatory stały się tak wydajne, że naturalne przewidywanie rozgałęzień w czasie wykonania jest często bardzo bliskie optimum. Aby PGO przyniosło realny zysk wydajności, trzeba mieć do czynienia z bardzo specyficznymi przypadkami, w których masa wykonywanego kodu znacznie przekracza to, co CPU jest fizycznie w stanie utrzymać w pamięci podręcznej.
Jak wczesna dereferencja wskaźnika może zniweczyć test bezpieczeństwa nullptr?
Jeśli wskaźnik jest dereferencjonowany na początku funkcji, kompilator stosuje agresywną optymalizację, zakładając, że wskaźnik jest prawidłowy, bo w przeciwnym razie nastąpiłaby natychmiastowa awaria. W rezultacie automatycznie usuwa wszystkie zabezpieczenia if (ptr == nullptr) znajdujące się dalej. Jeśli początkowa dereferencja nie przerwie procesu, zabezpieczenie znika w wyniku działania optymalizatora (pułapka, która dotknęła m.in. jądro Linuksa).
Jaka strategia najlepiej sprawdza się przy modernizacji kodu legacy z użyciem LLM?
Doświadczenie pokazuje, że bezpośrednie użycie LLM do modyfikowania ogromnej bazy kodu kończy się niepowodzeniem ze względu na jego niedeterministyczną naturę. Dobrą praktyką jest wykorzystanie LLM do tworzenia konkretnych, deterministycznych skryptów automatyzacji. Skrypt to kod, który inżynier może poddać audytowi, co pozwala zindustrializować zmiany poprzez dobrze rozdzielone, łatwe do zatwierdzenia przeglądy kodu (PR/commity).
Practice Software Engineering
Dołączyć do Practice Software Engineering w MARGO to wejść do zespołu 80 pasjonatów technologii. Nasza ambicja: połączyć wysokie standardy techniczne z siłą społeczności, by projektować solidne i innowacyjne rozwiązania programistyczne.
- Plemię i ekosystem: wsparcie 3 Practice Leaderów i udział w dedykowanej społeczności (C++, Java, C#/Python), by wymieniać się wiedzą podczas meetupów i afterworków.
- Ucz się i rozwijaj: 100% naszych pracowników co roku przechodzi szkolenia (C# Academy, globalne uniwersytety, bilety na Devoxx/Devfest) oraz ukierunkowany coaching kompetencji miękkich.
- Angażuj się i błyszcz: trampolina dla Twojej marki osobistej (artykuły, webinary, prasa) i konkretne zaangażowanie społeczne (wolontariat kompetencyjny z Latitudes, Open Data University).
Złożony projekt C++? Skontaktuj się z naszymi ekspertami.
Chcesz dołączyć do Ośrodka Doskonałości? Porozmawiajmy.