Czy zastanawiało Cię kiedyś, co naprawdę dzieje się na stercie (heap), gdy wpisujesz new MyObject()?
Za tą prostą linijką kodu kryje się złożony mechanizm alokacji pamięci, w którym liczy się każdy bajt. Aby opanować wydajność Javy, musisz odpowiedzieć na kilka podstawowych pytań:
- Czy kolejność pól w klasie wpływa na jej rozmiar?
- Jak ta sama klasa może mieć różny układ w pamięci w zależności od JVM?
- Jakie optymalizacje działające pod maską mogą po cichu zmniejszyć zużycie pamięci?
Dlaczego to ważne? Zrozumienie układu obiektów to nie tylko teoria. Mniejsze obiekty oznaczają większą gęstość danych na stercie, mniejsze obciążenie GC, lepszą lokalność danych w pamięci podręcznej, a w efekcie wyraźnie wyższą wydajność CPU.
W tej szczegółowej analizie zajrzymy do wnętrza HotSpot JVM, aby zobaczyć, jak przechowuje ona obiekty Javy w pamięci.
Rozłożymy na części adresy pamięci, skompresowane referencje (OOP) i wskaźniki klas, aby zobaczyć, jak składają się na ostateczny układ obiektu. Przeanalizujemy też, dlaczego nagłówki obiektów są często ukrytym „podatkiem” od Twojej sterty i jak Project Lilliput rewolucjonizuje Javę 25, czyniąc je mniejszymi niż kiedykolwiek.
Aby przełożyć teorię na praktykę, użyjemy JOL (Java Object Layout), narzędzia OpenJDK, które pozwala zbadać dokładną strukturę Twoich obiektów bajt po bajcie.
Uwaga:
Ten artykuł dotyczy wyłącznie 64-bitowej implementacji HotSpot JVM dostarczanej z Amazon Corretto 25. Niektóre omawiane tu szczegóły, zwłaszcza układ obiektów, nagłówki obiektów, skompresowane referencje i flagi JVM, zależą od implementacji i mogą nie działać dokładnie tak samo w innych implementacjach lub wersjach JVM. Ponadto rozmiary pamięci w tym artykule podajemy w jednostkach binarnych. Dla czytelności możemy pisać KB, MB i GB, ale należy je rozumieć jako KiB, MiB i GiB.
Krótkie przypomnienie: jak działają adresy pamięci
Zanim przejdziemy do szczegółów układu obiektów w Javie, wyjaśnijmy najpierw, jak działają adresy pamięci.
Na poziomie sprzętu pamięć można postrzegać jako długi ciąg bajtów. Każdy bajt ma własny adres, dzięki któremu procesor może zlokalizować dane zapisane w pamięci i uzyskać do nich dostęp.
W systemie 32-bitowym adresy pamięci są kodowane na 32 bitach. Oznacza to, że system może reprezentować maksymalnie:
2^32 = 4,294,967,296 ≈ 4 GB
Teoretycznie więc 32-bitowa przestrzeń adresowa pozwala zaadresować do 4 GB pamięci.
W systemie 64-bitowym adresy są kodowane na 64 bitach. Daje to znacznie większą teoretyczną przestrzeń adresową:
2^64 = 18,446,744,073,709,551,616 ≈ 16 EB
To około 16 EB adresowalnej pamięci.
Poniższy przykład pokazuje różnicę między adresowaniem 32-bitowym i 64-bitowym w zapisie szesnastkowym.
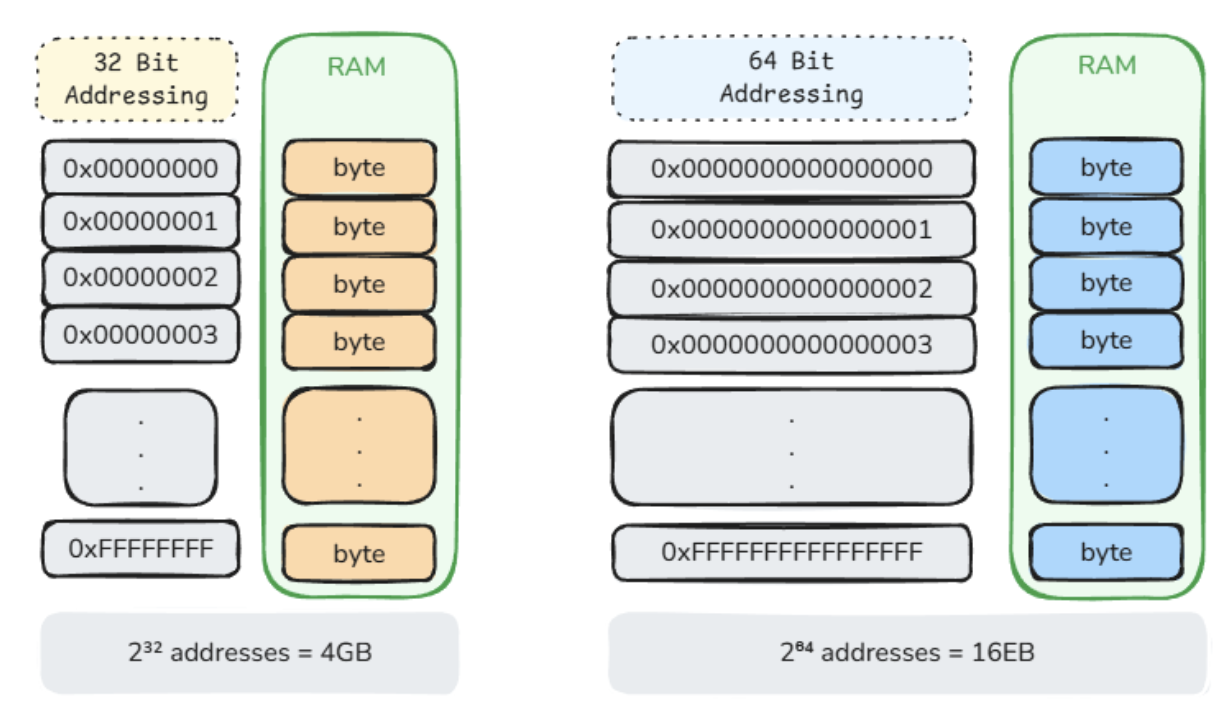
Na pierwszy rzut oka adresowanie 64-bitowe wydaje się oczywistym rozwiązaniem: więcej adresowalnej pamięci, mniej ograniczeń. Jest jednak pewien kompromis. Adres 64-bitowy jest dwa razy większy niż adres 32-bitowy, co oznacza, że referencje do obiektów mogą zajmować więcej pamięci.
W aplikacjach Java ma to znaczenie, bo referencje do obiektów są wszędzie: w obiektach, tablicach, kolekcjach i tak dalej. Jeśli każda referencja zajmuje więcej miejsca, cała sterta może się powiększyć.
Czy da się więc znaleźć kompromis między adresowaniem 32-bitowym a 64-bitowym? Czy można zachować zwartość wartości 32-bitowych, adresując jednocześnie więcej niż 4 GB pamięci? Zaskakująco tak – pod warunkiem, że przestaniemy myśleć w kategoriach pojedynczych bajtów.
Klasyczny adres 32-bitowy może reprezentować 2³² różnych wartości. Jeśli każda wartość wskazuje jeden bajt, otrzymujemy:
2³² × 1 byte = 4 GB
A gdyby każda wartość wskazywała nie pojedynczy bajt, lecz blok 8 bajtów?
2³² × 8 bytes = 32 GB
Tu przydają się wyrównanie i przesunięcie bitowe. Jeśli obiekty są wyrównane do granic 8 bajtów, ich adresy są zawsze wielokrotnościami 8:
0, 8, 16, 24, 32, …
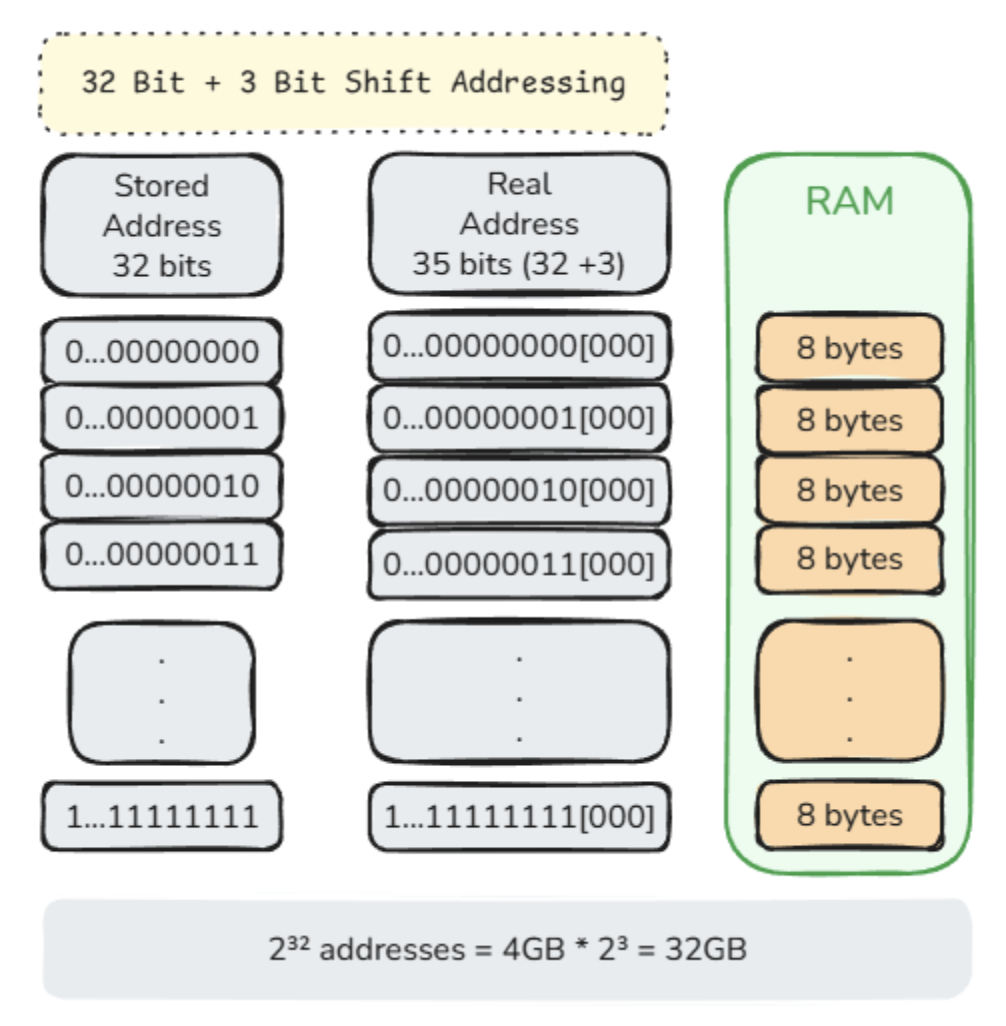
W zapisie binarnym wielokrotności 8 zawsze kończą się trzema bitami zerowymi. Skoro te bity są przewidywalne, nie trzeba ich przechowywać. Można zapisać mniejszą, 32-bitową wartość i odtworzyć rzeczywisty adres, przesuwając ją o 3 bity w lewo:
real address = stored value << 3
Innymi słowy, zapisana wartość nie jest już bezpośrednim adresem bajtu. Przypomina raczej indeks 8-bajtowych bloków pamięci:
stored value:  0   1   2   3   4
real address:  0   8   16  24  32
Daje to sprytny kompromis: referencje pozostają 32-bitowe, ale mogą adresować do 32 GB wyrównanej pamięci. Ta idea jest jednym z fundamentów skompresowanych referencji w HotSpot, którym przyjrzymy się za chwilę.
Poniższy przykład pokazuje adresowanie 32-bitowe z przesunięciem o 3 bity w zapisie binarnym.
Tę samą logikę można rozszerzyć na większe wartości wyrównania. Jeśli pamięć jest wyrównana do większych bloków, więcej najmłodszych bitów jest zawsze zerowych, więc w zapisanej referencji można pominąć więcej bitów:
8-byte alignment  -> 3-bit shift -> 2³² × 8  = 32 GB
16-byte alignment -> 4-bit shift -> 2³² × 16 = 64 GB
32-byte alignment -> 5-bit shift -> 2³² × 32 = 128 GB
Ma to jednak swoją cenę. Jeśli obiekty muszą zaczynać się na większych granicach, JVM może być zmuszona dodawać między nimi więcej nieużywanych bajtów, aby zachować wyrównanie. Te nieużywane bajty nazywamy dopełnieniem (padding). Więcej dopełnienia oznacza więcej zmarnowanej pamięci, co może prowadzić do fragmentacji wewnętrznej.
Na przykład przy wyrównaniu do 8 bajtów obiekt może potrzebować kilku bajtów dopełnienia, aby dojść do następnej granicy 8 bajtów. Przy wyrównaniu do 16 lub 32 bajtów dopełnienie może być większe. Większe wyrównanie zwiększa więc zakres adresowalnej sterty, ale może też obniżyć efektywność wykorzystania pamięci.
Ordinary Object Pointers
Skoro wiemy już, jak działają adresy pamięci, wróćmy do obiektów Javy.
Gdy w Javie tworzysz obiekt w ten sposób:
MyClass obj = new MyClass();
JVM alokuje pamięć dla nowego obiektu na stercie. Zmienna obj nie zawiera samego obiektu. Zawiera natomiast referencję, która pozwala JVM zlokalizować ten obiekt w pamięci.
W terminologii HotSpot taki rodzaj referencji nazywa się Ordinary Object Pointer, w skrócie zwykle OOP.
W 64-bitowej JVM zwykły wskaźnik obiektu jest reprezentowany jako wartość 64-bitowa, co oznacza, że zajmuje 8 bajtów. Daje to JVM dostęp do bardzo dużej przestrzeni adresowej, ale ma też istotną wadę: każda referencja do obiektu staje się większa. Gdy aplikacja zawiera miliony obiektów, ten narzut zaczyna mieć znaczenie.
Skompresowane OOP (Compressed OOPs)
Compressed OOPs, często zapisywane jako COOPs, to optymalizacja stosowana przez HotSpot JVM w celu zmniejszenia ilości pamięci zajmowanej przez referencje do obiektów.
Zamiast przechowywać referencje do obiektów jako pełne wartości 64-bitowe, HotSpot może zapisywać je jako skompresowane wartości 32-bitowe i dekodować je w razie potrzeby.
Idea opiera się na opisanym wcześniej mechanizmie wyrównania i przesunięcia bitowego.
Domyślne wyrównanie obiektów w HotSpot JVM wynosi 8 bajtów.
Gdy wyrównanie się zwiększa, rośnie też zakres adresowania:
ObjectAlignmentInBytes=8   -> 3-bit shift -> up to 32 GB
ObjectAlignmentInBytes=16  -> 4-bit shift -> up to 64 GB
ObjectAlignmentInBytes=32  -> 5-bit shift -> up to 128 GB
W praktyce skompresowane OOP są zwykle bardzo dobrą optymalizacją, bo wiele aplikacji Java nie potrzebuje sterty większej niż limit skompresowanych referencji. Dzięki referencjom 32-bitowym zamiast 64-bitowych JVM może znacznie zmniejszyć zużycie sterty, zwiększyć gęstość obiektów, ograniczyć obciążenie GC i poprawić lokalność danych w pamięci podręcznej.
HotSpot domyślnie włącza skompresowane OOP. Jeśli jednak sterta jest zbyt duża, by dało się ją opisać skompresowanymi OOP przy wybranym wyrównaniu, HotSpot wraca do pełnych 64-bitowych zwykłych wskaźników obiektów.
Możesz je jawnie wyłączyć za pomocą:
-XX:-UseCompressedOops
A wyrównanie obiektów możesz skonfigurować za pomocą:
-XX:ObjectAlignmentInBytes=8
Badanie układu JVM za pomocą JOL
Do tej pory omawialiśmy referencje, czyli OOP, skompresowane OOP, wyrównanie i przesunięcie bitowe od strony teoretycznej. Sprawdźmy teraz, czego JVM faktycznie używa.
Możemy w tym celu użyć JOL, czyli narzędzia Java Object Layout z OpenJDK. JOL służy do badania układu obiektów, rozmiarów pól i referencji, wyrównania oraz innych niskopoziomowych szczegółów układu JVM. Artefakt jol-core jest dostępny w Maven Central jako org.openjdk.jol:jol-core.
Możemy poprosić JOL o wyświetlenie szczegółów układu bieżącej JVM:
void main() {
   IO.println(VM.current().details());
}
W moim środowisku, z 64-bitową HotSpot JVM dostarczaną z Amazon Corretto 25, wynik wygląda tak:
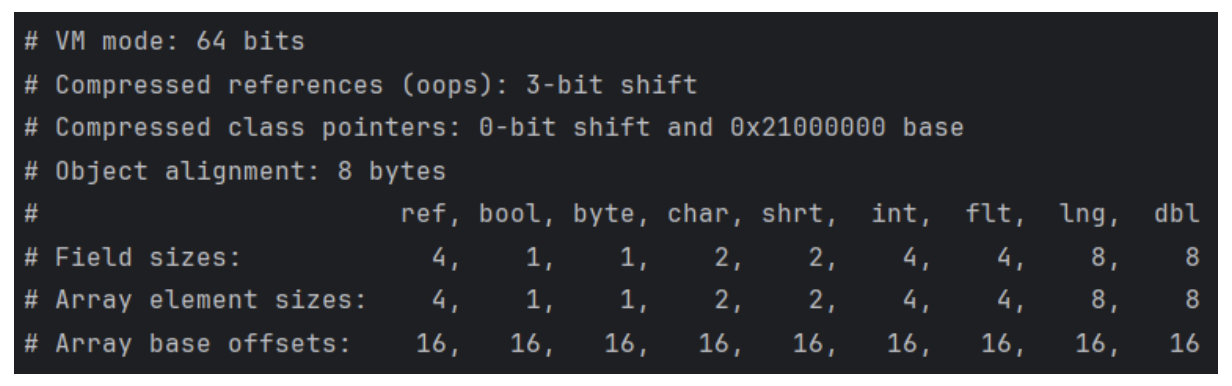
Ten wynik potwierdza kilka ważnych rzeczy.
Po pierwsze, JVM działa w trybie 64-bitowym:
# VM mode: 64 bits
Po drugie, referencje do obiektów są skompresowane:
# Compressed references (oops): 3-bit shift
Dlaczego 3 bity? Ponieważ JVM zgłasza:
# Object alignment: 8 bytes
Zgadza się to z wyjaśnieniem z poprzedniej sekcji.
Do skompresowanych wskaźników klas wrócimy w dalszej części artykułu.
JOL podaje też rozmiar pól referencyjnych i pól typów prostych:
#                       ref, bool, byte, ...
# Array element sizes:    4,    1,    1, …
Pierwsza wartość, ref = 4, oznacza, że pola referencyjne obiektów zajmują 4 bajty przy włączonych skompresowanych OOP.
To samo dotyczy tablic referencji:
#                       ref, bool, byte, ...
# Array element sizes:    4,    1,    1, …
Tablica Object[] przechowuje więc każdą referencję na 4 bajtach, gdy skompresowane OOP są włączone.
Na koniec JOL podaje:
#                       ref, bool, byte, ...
# Array base offsets:    16,   16,   16, …
Oznacza to, że w tej konfiguracji JVM pierwszy element każdej tablicy zaczyna się 16 bajtów od początku obiektu tablicy. Wcześniejsze bajty JVM wykorzystuje na nagłówek tablicy, w tym metadane obiektu i długość tablicy. Wrócimy do tego później, gdy będziemy szczegółowo analizować nagłówki obiektów i układ tablic.
Jeśli jawnie wyłączymy skompresowane OOP za pomocą -XX:-UseCompressedOops albo skonfigurujemy JVM z rozmiarem sterty przekraczającym zakres adresowania skompresowanych OOP, HotSpot wyłączy skompresowane referencje i wróci do pełnych 64-bitowych zwykłych wskaźników obiektów.
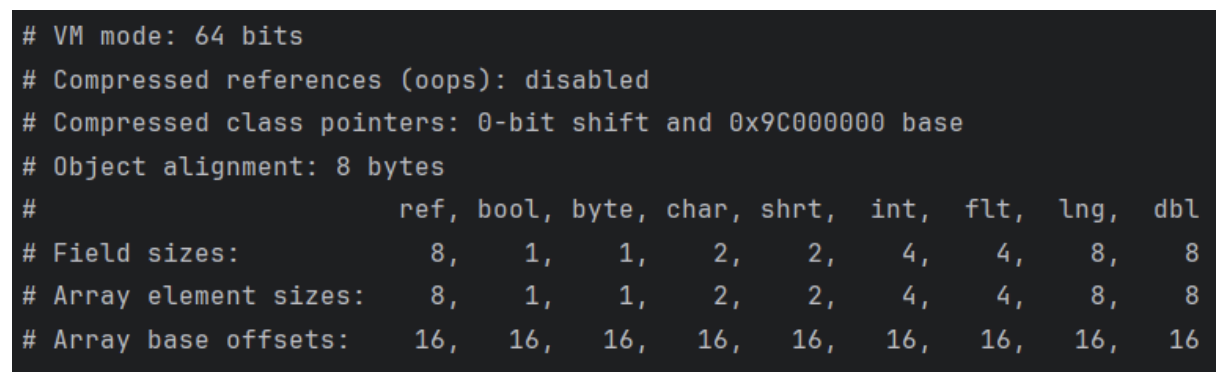
Jak widać w wyniku JOL, skompresowane referencje są teraz wyłączone:
# Compressed references (oops): disabled
W konsekwencji pola referencyjne i elementy tablic referencji zajmują teraz 8 bajtów zamiast 4:
#                       ref, ...
# Field sizes:            8, ...
# Array element sizes:    8, …
Oznacza to, że każda referencja do obiektu zapisana w polu obiektu lub w tablicy obiektów zużywa teraz dwa razy więcej pamięci niż w konfiguracji ze skompresowanymi OOP.
Metaspace i metadane klas
Gdy JVM widzi obiekt w pamięci, musi wiedzieć, co ten obiekt reprezentuje. Na przykład:
- Jaka jest jego klasa?
- Jakie ma pola?
- Jakie metody są dostępne?
- Jaka jest jego nadklasa?
- Jakie interfejsy implementuje?
Te informacje nie są przechowywane w każdym obiekcie osobno. Byłoby to skrajne marnotrawstwo. HotSpot przechowuje natomiast współdzielone metadane środowiska uruchomieniowego dla każdej załadowanej klasy.
Te metadane znajdują się poza stertą Javy, w obszarze pamięci natywnej o nazwie Metaspace.
Innymi słowy, Metaspace to pamięć poza stertą (off-heap), którą zarządza sama JVM. Zawiera reprezentację załadowanych klas Javy w czasie działania.
Metadane klas obejmują m.in. takie struktury jak:
Klass(struktury klas),- metadane metod,
- pule stałych (constant pools),
- adnotacje,
- oraz inne struktury potrzebne JVM w czasie działania.
Obiekty Javy żyją więc na stercie, a metadane opisujące ich klasy – w Metaspace.
Przed Javą 8 te metadane były przechowywane w Permanent Generation (PermGen). Od Javy 8 PermGen usunięto i zastąpiono przestrzenią Metaspace.
Każdy obiekt wskazuje metadane swojej klasy
Obiekty Javy nie przenoszą bezpośrednio informacji o swojej klasie. Każdy obiekt przechowuje jedynie wskaźnik do swojej struktury Klass – same współdzielone metadane klasy istnieją w Metaspace w jednym egzemplarzu.
Struktura Klass to wewnętrzna reprezentacja załadowanej klasy Javy w JVM. Zawiera metadane potrzebne do opisania tej klasy w czasie działania: jej nazwę, nadklasę, implementowane interfejsy, układ pól itd. Dzięki tej strukturze HotSpot może ustalić klasę obiektu w czasie działania i poprawnie zinterpretować jego układ w pamięci.
Koncepcyjnie wygląda to tak:
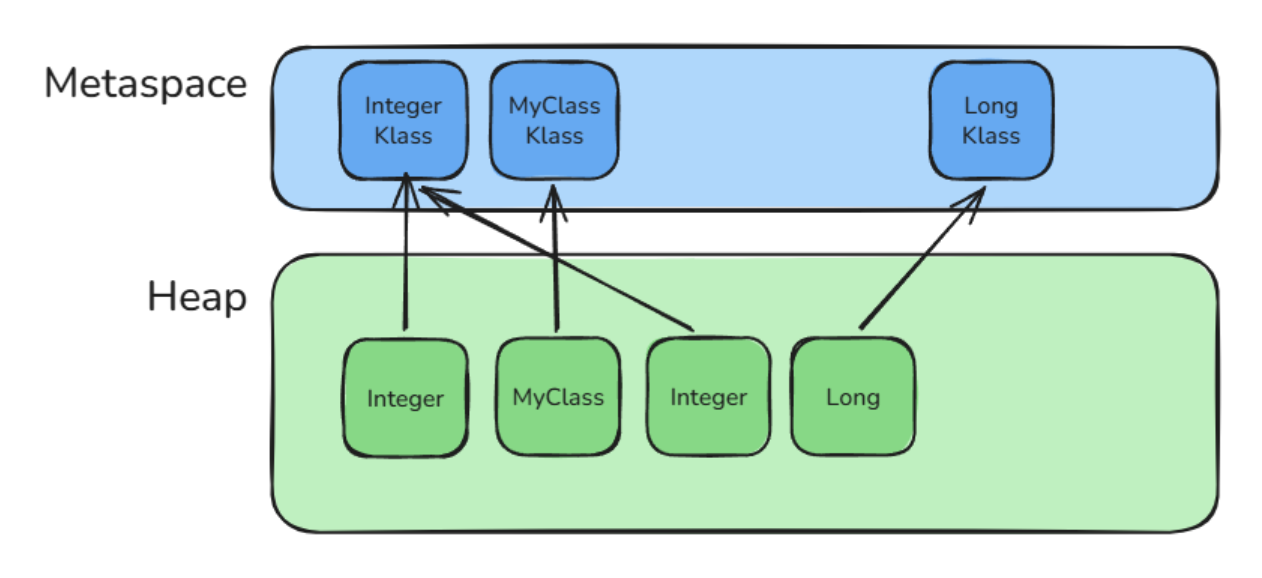
W 64-bitowej HotSpot JVM wskaźnik do struktury Klass byłby naturalnie 64-bitowym wskaźnikiem natywnym, czyli zajmowałby 8 bajtów.
Skompresowane wskaźniki klas (Compressed Class Pointers)
Tak jak można kompresować zwykłe wskaźniki obiektów, HotSpot potrafi też kompresować wskaźniki do metadanych klas.
Ta optymalizacja nosi nazwę Compressed Class Pointers. Gdy jest włączona, wskaźnik klass zapisany w nagłówkach obiektów korzysta z 32-bitowej skompresowanej reprezentacji zamiast pełnego 64-bitowego wskaźnika natywnego.
Przy włączonych skompresowanych wskaźnikach klas HotSpot dzieli Metaspace na dwa obszary logiczne:
- Compressed Class Space
- oraz Non-Class Space.
Compressed Class Space to zarezerwowany obszar pamięci natywnej przeznaczony na struktury Klass – ponieważ skompresowane wskaźniki klas mają tylko 32 bity, JVM musi umieścić te struktury w ograniczonym zakresie adresów, tak aby nadal dało się je adresować skompresowanymi wskaźnikami.
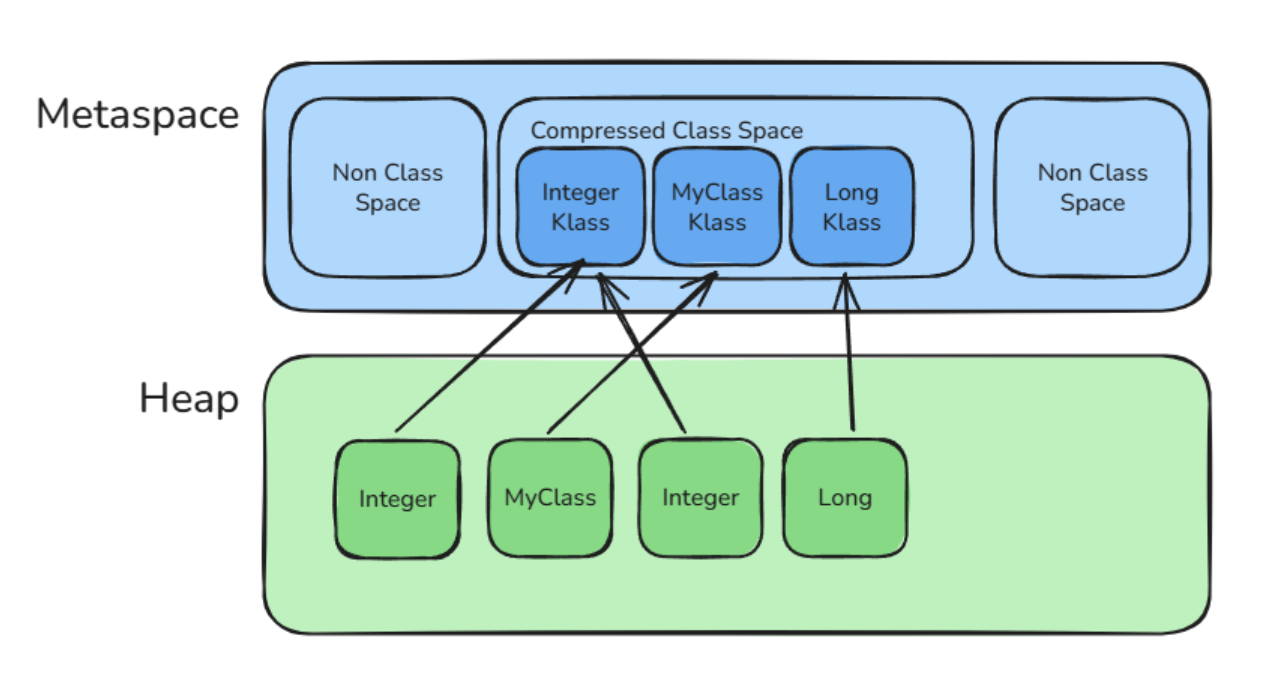
Rozmiarem Compressed Class Space steruje następująca flaga JVM:
-XX:CompressedClassSpaceSize
Ponieważ HotSpot musi zarezerwować Compressed Class Space z góry, ta wartość nie może pozostać nieokreślona. Jeśli flaga nie zostanie jawnie podana, JVM używa domyślnej wartości 1 GB.
Struktura Klass zajmuje zwykle od 512 do 1024 bajtów, średnio około 768 bajtów.
Na podstawie tego przybliżenia domyślna Compressed Class Space o rozmiarze 1 GB może pomieścić około 1,4 mln struktur Klass według poniższego obliczenia:
1 GB / 768 bytes ≈ 1,398,101 Klass structures
Warto zwrócić uwagę na ważny limit: HotSpot ogranicza wartość CompressedClassSpaceSize do 4 GB.
Przy włączonych skompresowanych wskaźnikach klas górna granica wynosi więc:
4 GB / 768 bytes ≈ = 5,592,447 Klass structures
Innymi słowy, przy maksymalnym rozmiarze Compressed Class Space limit wynosi około 5,6 mln struktur Klass – w praktyce to wartość ogromna jak na rzeczywiste aplikacje. Nawet bardzo duże aplikacje korporacyjne ładują zwykle najwyżej kilkadziesiąt tysięcy klas.
Oczywiście to tylko uproszczony szacunek. Rzeczywista liczba zależy od faktycznego rozmiaru każdej struktury Klass – a ten zależy od kształtu klasy, liczby pól, metod, interfejsów i innych metadanych.
HotSpot włącza Compressed Class Pointers domyślnie.
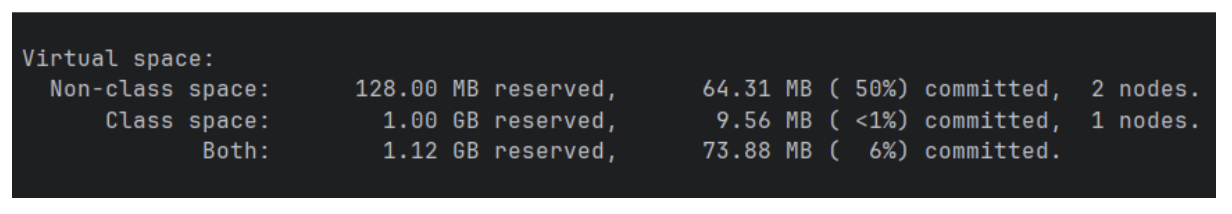
Badanie Metaspace za pomocą jcmd
Wykorzystanie Metaspace w czasie działania możemy sprawdzić za pomocą jcmd.
Najpierw znajdź identyfikator procesu (PID) uruchomionej aplikacji Java:
jcmd
Następnie uruchom:
jcmd <PID> VM.metaspace
To polecenie wyświetla szczegółowe informacje o Metaspace, w tym o wykorzystaniu Compressed Class Space i Non-Class Space.
Układ obiektu w pigułce
Do tej pory omówiliśmy zwykłe wskaźniki obiektów, skompresowane zwykłe wskaźniki obiektów, wskaźniki klas i skompresowane wskaźniki klas.
Mamy już wszystkie elementy potrzebne, by zrozumieć, jak obiekt Javy jest faktycznie rozmieszczony na stercie.
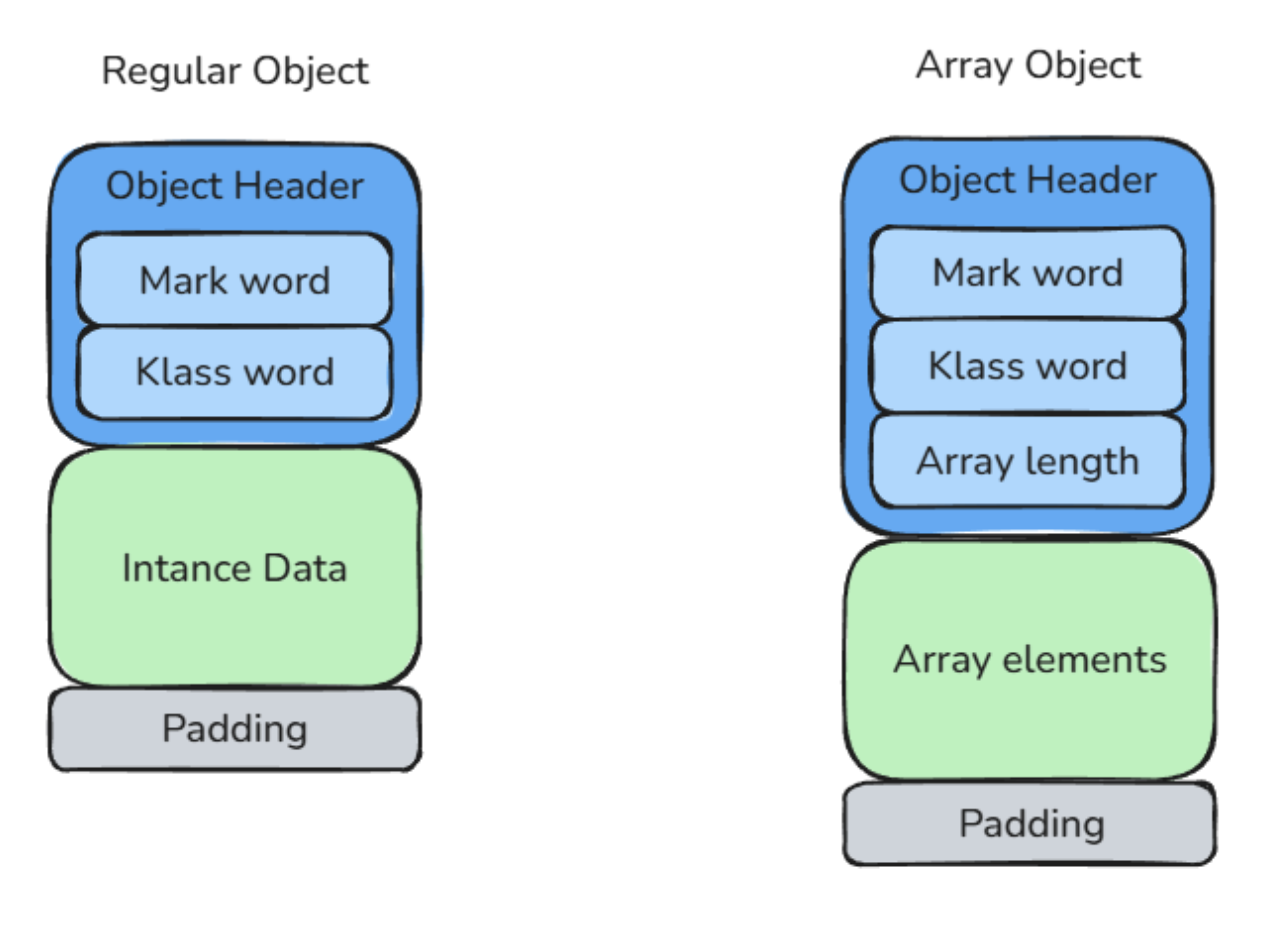
W HotSpot każdy obiekt przechowywany na stercie ma ściśle określoną strukturę pamięci. Koncepcyjnie obiekt składa się z trzech głównych części:
- nagłówka obiektu,
- danych instancji,
- oraz opcjonalnego dopełnienia (padding).
Pierwszy element, nagłówek obiektu, to metadane zapisywane przez HotSpot na początku każdego obiektu. Pozwalają one HotSpot zarządzać obiektem w czasie działania. Nagłówek składa się z dwóch głównych części: Mark Word i Klass Word. W przypadku tablic nagłówek zawiera też długość tablicy.
Drugi element, dane instancji, zawiera faktyczne pola zadeklarowane w klasie Javy.
Trzeci element, dopełnienie (padding), składa się z nieużywanych bajtów dodawanych przez JVM, aby spełnić wymagania wyrównania. Ponieważ obiekty są wyrównywane do określonych granic, domyślnie zwykle 8 bajtów, HotSpot może być zmuszony dodać dodatkowe bajty, tak aby następny obiekt zaczynał się pod poprawnie wyrównanym adresem.
W uproszczeniu obiekt wygląda więc tak:
W kolejnych sekcjach przyjrzymy się bliżej każdej z tych części, zaczynając od nagłówka obiektu.
Nagłówek obiektu: Mark Word
Słowo Mark Word to 64-bitowe pole zapisane na początku nagłówka każdego obiektu Javy.
Zawiera kilka rodzajów metadanych, których HotSpot potrzebuje w czasie działania do zarządzania obiektem:
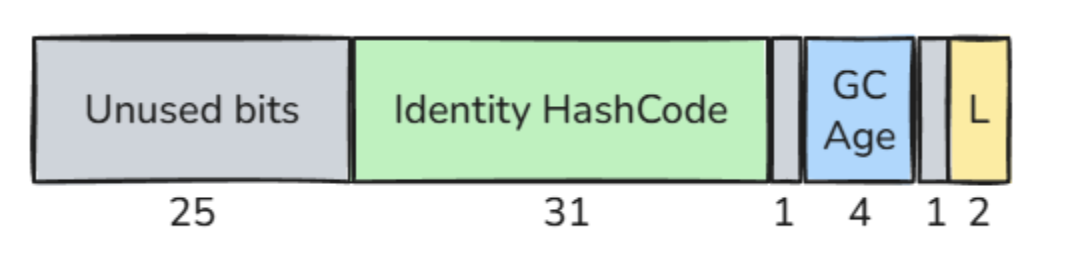
25 bits  Unused bits
31 bits  Identity hash code
1  bit   Unused historical bit (CMS)
4  bits  Object age
1  bit   Unused historical bit (Biased Locking)
2 bits   Lock state
Pole identity hash code przechowuje wartość zwracaną przez System.identityHashCode(object). Zajmuje 31 bitów.
Pole wiek obiektu (age) jest wykorzystywane przez garbage collector. Określa, ile odśmiecań młodej generacji obiekt przetrwał. Ta wartość zajmuje 4 bity.
Dwa bity blokady (lock bits) opisują stan synchronizacji obiektu. Są używane, gdy obiekt bierze udział w synchronizacji i służy jako monitor. W zależności od sytuacji mogą reprezentować stany takie jak: odblokowany, zablokowany, napompowany (inflated) lub przekierowany (forwarded).
Niektóre bity mają też znaczenie historyczne.
Bit nr 7 był wcześniej używany przez kolektor Concurrent Mark-Sweep, znany też jako CMS. Ponieważ CMS usunięto w Javie 17, ten bit nie służy już do tego celu.
Bit nr 2 był wcześniej używany do blokowania stronniczego (biased locking). Ponieważ biased locking usunięto w Javie 19, ten bit również nie służy już do tego celu.
W efekcie w obecnej implementacji HotSpot część słowa Mark Word pozostaje nieużywana (27 bitów). To jeden z powodów, dla których Project Lilliput może na nowo przemyśleć sposób reprezentowania metadanych nagłówka i uczynić nagłówek obiektu bardziej zwartym.
Nagłówek obiektu: Klass Word
Słowo Klass Word, nazywane też wskaźnikiem klasy, pozwala JVM poznać typ obiektu.
Wskazuje strukturę Klass obiektu, przechowywaną w Metaspace i zawierającą metadane klasy używane w czasie działania.
Jak widzieliśmy wcześniej, ten wskaźnik może być przechowywany w dwóch różnych postaciach.
- Bez skompresowanych wskaźników klas Klass Word zajmuje 8 bajtów.
- Przy włączonych skompresowanych wskaźnikach klas zajmuje tylko 4 bajty.
Dlatego skompresowane wskaźniki klas bezpośrednio wpływają na rozmiar nagłówka obiektu.
Nagłówek obiektu: długość tablicy
Tablice też są obiektami, ale potrzebują jednej dodatkowej informacji: swojej długości.
JVM musi wiedzieć, ile elementów zawiera tablica, aby sprawdzać zakresy indeksów, obliczać przesunięcia elementów i bezpiecznie odczytywać zawartość tablicy.
Ta długość jest zapisana bezpośrednio w nagłówku tablicy jako 4-bajtowa liczba całkowita.
To pole istnieje tylko w obiektach tablic. Zwykłe obiekty nie mają pola długości tablicy.
Dane instancji
Po nagłówku obiektu następują dane instancji.
To tutaj HotSpot przechowuje faktyczne pola zadeklarowane w klasie Javy.
Na przykład:
class User {
   long id;
   int age;
   boolean active;
}
Wartości id, age i active są przechowywane w części obiektu przeznaczonej na dane instancji.
Każde pole zajmuje miejsce zależne od swojego typu:
boolean / byte  -> 1 byte
char / short    -> 2 bytes
int / float     -> 4 bytes
long / double   -> 8 bytes
reference       -> 4 bytes with compressed oops, 8 bytes otherwise
Aby ograniczyć marnowanie pamięci, HotSpot nie musi przechowywać pól obiektu w tej samej kolejności, w jakiej zadeklarowano je w kodzie źródłowym Javy.
Może natomiast przestawić pola w pamięci, aby uzyskać bardziej zwarty układ i ograniczyć dopełnienie.
Układ podlega kilku ważnym regułom.
Po pierwsze, każde pole musi zostać umieszczone pod przesunięciem (offsetem) zgodnym z jego rozmiarem. Na przykład 4-bajtowy int jest umieszczany pod offsetem będącym wielokrotnością 4, a 8-bajtowy long lub double – pod offsetem będącym wielokrotnością 8. Gdy pod bieżącym offsetem brakuje miejsca, HotSpot wstawia bajty dopełnienia, aby wypełnić lukę.
Po drugie, HotSpot grupuje pola według rozmiaru, aby ograniczyć fragmentację wewnętrzną. Najpierw umieszcza większe pola, a potem mniejsze. Koncepcyjnie kolejność wygląda tak:
longs and doubles
ints and floats
chars and shorts
bytes and booleans
references
Po trzecie, znaczenie ma także dziedziczenie. HotSpot rozmieszcza najpierw pola nadklasy, a dopiero potem dodaje pola zadeklarowane w podklasie.
W efekcie fizyczna kolejność pól w pamięci może różnić się od kolejności zapisanej w klasie Javy.
Dopełnienie (padding)
Po rozmieszczeniu pól instancji HotSpot może jeszcze dodać dopełnienie na końcu obiektu, tak aby jego całkowity rozmiar był zgodny ze skonfigurowanym wyrównaniem obiektów.
Dlatego zużycie pamięci przez obiekt to nie tylko suma jego pól. To suma:
object header + instance data + padding
Badanie rzeczywistego układu obiektów za pomocą JOL
Do tej pory omawialiśmy nagłówki obiektów, dane instancji, skompresowane wskaźniki i wyrównanie od strony koncepcyjnej.
Jak jednak wygląda rzeczywisty układ pamięci tworzony przez JVM?
Aby odpowiedzieć na to pytanie, możemy użyć JOL, narzędzia Java Object Layout z OpenJDK. JOL pozwala sprawdzić, jak HotSpot organizuje obiekty w pamięci, w tym:
- nagłówki obiektów,
- przesunięcia (offsety) pól,
- dopełnienie,
- luki wyrównania,
- oraz końcowy rozmiar obiektu.
Daje nam to konkretny sposób na sprawdzenie omówionych dotąd koncepcji.
W kolejnych przykładach użyjemy ClassLayout.parseClass(...).toPrintable() do zbadania układu pamięci generowanego przez JVM.
Przykład 1: pusty obiekt
class Empty {
}

void main() {
   IO.print(ClassLayout.parseClass(Empty.class).toPrintable());
}
W 64-bitowej HotSpot JVM wynik wygląda tak:
OFF  SZ   TYPE DESCRIPTION                VALUE
 0   8        (object header: mark)     N/A
 8   4        (object header: class)    N/A
12   4        (object alignment gap)
Instance size: 16 bytes
Space losses: 0 bytes internal + 4 bytes external = 4 bytes total
Ten wynik ilustruje kilka ważnych zagadnień.
Obiekt zaczyna się od:
- 8-bajtowego słowa Mark Word,
- po którym następuje 4-bajtowe skompresowane słowo Klass Word.
W tym momencie obiekt zajmuje 12 bajtów.
HotSpot domyślnie wyrównuje jednak obiekty do granic 8 bajtów. Ponieważ 12 nie jest wielokrotnością 8, JVM dodaje 4 bajty dopełnienia.
W rezultacie nawet pusty obiekt Javy zajmuje 16 bajtów.
Przykład 2: prosty obiekt z polami
class User {
   int age;
   long id;
   boolean active;
}

void main() {
   IO.print(ClassLayout.parseClass(User.class).toPrintable());
}
OFF  SZ      TYPE DESCRIPTION                VALUE
 0   8           (object header: mark)     N/A
 8   4           (object header: class)    N/A
12   4       int User.age                  N/A
16   8      long User.id                   N/A
24   1   boolean User.active               N/A
25   7           (object alignment gap)
Instance size: 32 bytes
Space losses: 0 bytes internal + 7 bytes external = 7 bytes total
Warto tu zauważyć kilka rzeczy.
Po pierwsze, pola niekoniecznie eliminują dopełnienie. Mimo że obiekt zawiera tylko:
- 4 bajty na pole
age, - 8 bajtów na pole
id, - 1 bajt na pole
active,
jego całkowity rozmiar wynosi 32 bajty.
Dzieje się tak, ponieważ HotSpot musi poprawnie wyrównać zarówno pola, jak i granice obiektu.
Pole boolean zajmuje tylko 1 bajt, ale końcowy rozmiar obiektu i tak musi zostać zaokrąglony w górę do najbliższej wielokrotności wyrównania obiektów.
W rezultacie HotSpot dodaje na końcu 7 bajtów dopełnienia.
Przykład 3: zmiana kolejności pól i dopełnienie
class Reordering {
   Reordering reordering;
   boolean enabled;
}

void main() {
   IO.print(ClassLayout.parseClass(Reordering.class).toPrintable());
}
Choć pole referencyjne zadeklarowano przed polem boolean w klasie, JOL wyświetla następujący układ:
OFF  SZ               TYPE DESCRIPTION                VALUE
 0   8                    (object header: mark)     N/A
 8   4                    (object header: class)    N/A
12   1            boolean Reordering.enabled        N/A
13   3                    (alignment/padding gap)
16   4   Main.Reordering Reordering.reordering     N/A
20   4                    (object alignment gap)
Instance size: 24 bytes
Space losses: 3 bytes internal + 4 bytes external = 7 bytes total
Jak wspomnieliśmy wcześniej, HotSpot może zmieniać kolejność pól. W tym przypadku pole boolean zostaje umieszczone przed polem referencyjnym, mimo że w kodzie źródłowym referencja jest zadeklarowana jako pierwsza.
Ponieważ pole boolean zajmuje tylko 1 bajt, zostaje umieszczone pod offsetem 12, zaraz za nagłówkiem obiektu.
Pole referencyjne zajmuje 4 bajty przy włączonych skompresowanych OOP, więc musi znaleźć się pod offsetem będącym wielokrotnością 4. Najbliższy poprawny offset po 13 to 16, dlatego HotSpot dodaje 3 bajty luki wyrównania/dopełnienia między polem boolean a polem referencyjnym.
Przykład 4: wyłączenie skompresowanych OOP i skompresowanych wskaźników klas
Uruchommy teraz ten sam przykład ponownie, tym razem z wyłączonymi skompresowanymi zwykłymi wskaźnikami obiektów i skompresowanymi wskaźnikami klas:
java -XX:-UseCompressedOops -XX:-UseCompressedClassPointers …
Zostawiamy tę samą klasę:
class Reordering {
   Reordering reordering;
   boolean enabled;
}

void main() {
   IO.print(ClassLayout.parseClass(Reordering.class).toPrintable());
}
W tej konfiguracji zarówno wskaźnik klasy, jak i referencja do obiektu są przechowywane jako pełne wartości 64-bitowe.
OFF  SZ               TYPE DESCRIPTION                VALUE
 0   8                    (object header: mark)     N/A
 8   8                    (object header: class)    N/A
16   1            boolean Reordering.enabled        N/A
17   7                    (alignment/padding gap)
24   8   Main.Reordering Reordering.reordering     N/A
Instance size: 32 bytes
Space losses: 7 bytes internal + 0 bytes external = 7 bytes total
Tym razem nagłówek obiektu zajmuje 16 bajtów. Pole referencyjne również zajmuje 8 bajtów, bo skompresowane OOP są wyłączone.
Jak wspomnieliśmy wcześniej, pole boolean zostaje umieszczone przed polem referencyjnym. Znajduje się pod offsetem 16 i zajmuje 1 bajt.
Pole referencyjne musi teraz znaleźć się pod offsetem będącym wielokrotnością 8. Najbliższy poprawny offset po 17 to 24, dlatego HotSpot dodaje 7 bajtów luki wyrównania/dopełnienia między polem boolean a polem referencyjnym.
Przykład 5: układ tablicy
Tablice mają nieco inną strukturę, bo w nagłówku przechowują też swoją długość. Zwróć uwagę, że badając rzeczywiste instancje obiektów, używamy ClassLayout.parseInstance() zamiast ClassLayout.parseClass().
void main() {
   IO.print(ClassLayout.parseInstance(new int [5]).toPrintable());
}
OFF  SZ   TYPE DESCRIPTION                VALUE
 0   8        (object header: mark)     0x0000000000000001
 8   4        (object header: class)    0x00184b48
12   4        (array length)             5
16  20    int [I.<elements>             N/A
36   4        (object alignment gap)
Instance size: 40 bytes
Space losses: 0 bytes internal + 4 bytes external = 4 bytes total
Pierwsze 16 bajtów to nagłówek tablicy:
- 8 bajtów na Mark Word,
- 4 bajty na skompresowane Klass Word,
- 4 bajty na długość tablicy.
Elementy tablicy zaczynają się bezpośrednio za nagłówkiem.
Ponieważ tablica zawiera 5 liczb całkowitych:
5 × 4 bytes = 20 bytes
Łącznie daje to:
16 + 20 = 36 bytes
Na koniec HotSpot dodaje 4 bajty dopełnienia, więc całkowity rozmiar obiektu wynosi 40 bajtów.
Project Lilliput i kompaktowe nagłówki obiektów
Widać już wyraźnie, że nagłówki obiektów nie są tanie.
Nawet najprostszy obiekt Javy zajmuje zwykle co najmniej 16 bajtów, zanim zapisze jakiekolwiek użyteczne dane aplikacji. W przypadku małych obiektów nagłówek może stanowić bardzo duży odsetek całkowitego zużycia pamięci.
Na przykład obiekt zawierający tylko jedno pole boolean może nadal zajmować 16, a nawet 24 bajty, w zależności od konfiguracji JVM i wymagań wyrównania.
Gdy aplikacja tworzy miliony lub miliardy obiektów, ten narzut zaczyna mieć duże znaczenie.
Właśnie ten problem próbuje rozwiązać Project Lilliput.
Project Lilliput to projekt OpenJDK, którego celem jest zmniejszenie rozmiaru nagłówków obiektów Javy w HotSpot.
Główna idea Project Lilliput polega na zmniejszeniu tego nagłówka z 12/16 bajtów do jednego 8-bajtowego słowa. Ta optymalizacja nosi nazwę Compact Object Headers.
Koncepcyjnie JVM stara się połączyć w jednym 64-bitowym słowie Mark Word: informacje o blokadzie, metadane GC, identity hash code i wskaźnik klasy.
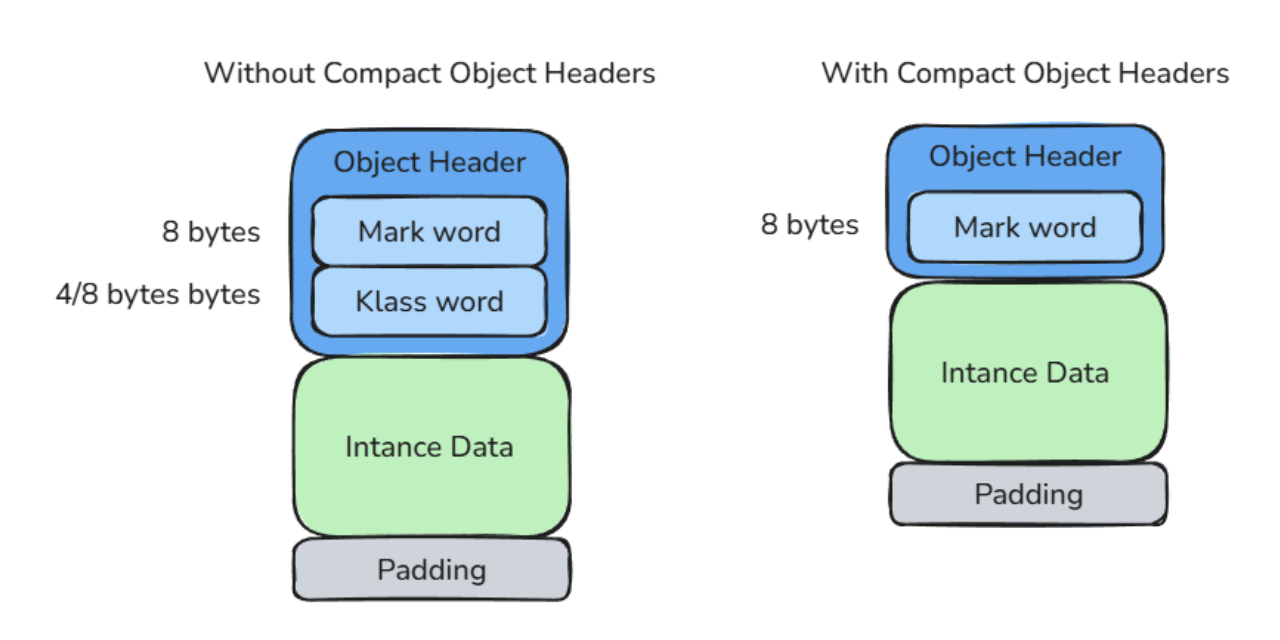
Jak JVM udaje się zmieścić to wszystko w jednym 64-bitowym nagłówku?
Aby to zrozumieć, wróćmy do słowa Mark Word.
Jak widzieliśmy wcześniej, Mark Word zajmuje już 64 bity. Przechowuje takie informacje jak identity hash code, wiek obiektu i stan blokady. Nie wszystkie jego bity są jednak aktywnie wykorzystywane. W obecnym układzie kilka bitów wciąż pozostaje wolnych.
Project Lilliput wykorzystuje tę niewykorzystaną przestrzeń.
Wyzwaniem jest Klass Word. Przy włączonych skompresowanych wskaźnikach klas Klass Word zajmuje zwykle 32 bity. Jeśli chcemy włączyć go do słowa Mark Word, musimy go zmniejszyć.
Tu znów wraca temat wyrównania.
Widzieliśmy wcześniej, że skompresowane zwykłe wskaźniki obiektów działają dzięki wyrównaniu obiektów. Ponieważ obiekty są wyrównane do granic 8 bajtów, ich adresy zawsze kończą się trzema bitami zerowymi. JVM może te bity pominąć, a później odtworzyć rzeczywisty adres, przesuwając skompresowaną wartość.
Project Lilliput stosuje podobną ideę do metadanych klas.
Struktury Klass w Compressed Class Space są wyrównane do granic 1024 bajtów. Ponieważ 10 najmłodszych bitów ich adresów to zawsze zera, JVM nie musi tych 10 bitów przechowywać.
Skompresowany wskaźnik klasy można więc skompresować jeszcze bardziej:
32 bits - 10 bits = 22 bits
Tak zmniejszony, 22-bitowy wskaźnik klasy mieści się teraz w 64-bitowym słowie Mark Word. Nawet po skompresowaniu wskaźnika klasy do 22 bitów HotSpot wciąż może zaadresować do 4 194 304 struktur Klass – to nadal w zupełności wystarcza dla rzeczywistych aplikacji.
Po wstawieniu skompresowanego wskaźnika klasy zostaje jeszcze kilka wolnych bitów. Są one wykorzystywane na dodatkowe metadane JVM:
1 bit   self-forwarded tag used by the garbage collector
4 bits  reserved for Project Valhalla value objects
Wcześniej słowo Mark Word wyglądało tak:
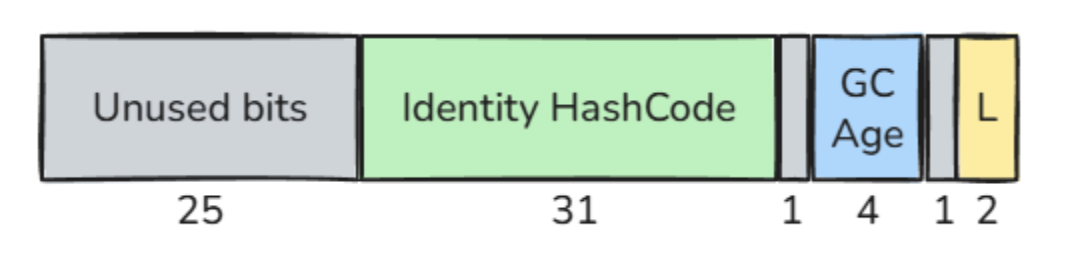
Teraz nowe słowo Mark Word wygląda tak:
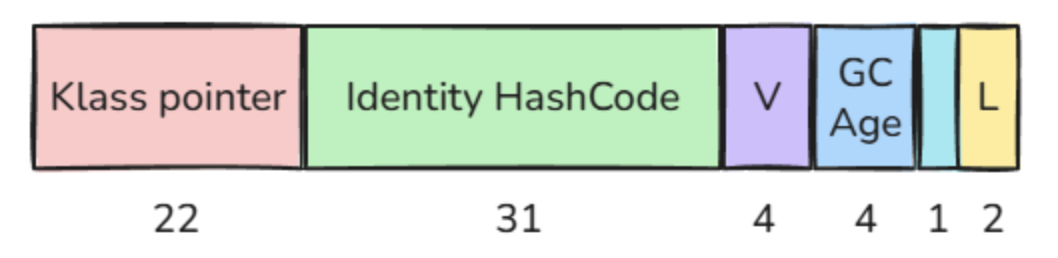
W tej nowej strukturze żaden bit nie pozostaje już niewykorzystany. Nagłówek obiektu jest teraz w całości upakowany w jednym 64-bitowym słowie.
Aby włączyć kompaktowe nagłówki obiektów, uruchom aplikację z opcją:
-XX:+UseCompactObjectHeaders
Kompaktowe nagłówki obiektów wymagają włączonych skompresowanych wskaźników klas, a od JDK 25 opcja UseCompressedClassPointers jest oznaczona jako przestarzała (deprecated) i prawdopodobnie zostanie usunięta w jednej z przyszłych wersji.
Skoro rozumiemy już ideę kompaktowych nagłówków obiektów, sprawdźmy ją za pomocą JOL i porównajmy rzeczywiste układy tworzone przez HotSpot.
Przykład 1: pusty obiekt
class Empty {
}

void main() {
   IO.print(ClassLayout.parseClass(Empty.class).toPrintable());
}
Bez kompaktowych nagłówków obiektów:
OFF  SZ   TYPE DESCRIPTION                VALUE
 0   8        (object header: mark)     N/A
 8   4        (object header: class)    N/A
12   4        (object alignment gap)
Instance size: 16 bytes
Space losses: 0 bytes internal + 4 bytes external = 4 bytes total
Z kompaktowymi nagłówkami obiektów:
OFF  SZ   TYPE DESCRIPTION                VALUE
 0   8        (object header: mark)     N/A
Instance size: 8 bytes
Space losses: 0 bytes internal + 0 bytes external = 0 bytes total
Rozmiar obiektu spada z 16 do 8 bajtów.
Saved memory: 8 bytes
Reduction: 50%
Przykład 2: obiekt z polami typów prostych
class User {
   int age;
   long id;
   boolean active;
}

void main() {
   IO.print(ClassLayout.parseClass(User.class).toPrintable());
}
Bez kompaktowych nagłówków obiektów:
OFF  SZ      TYPE DESCRIPTION                VALUE
 0   8           (object header: mark)     N/A
 8   4           (object header: class)    N/A
12   4       int User.age                  N/A
16   8      long User.id                   N/A
24   1   boolean User.active               N/A
25   7           (object alignment gap)
Instance size: 32 bytes
Space losses: 0 bytes internal + 7 bytes external = 7 bytes total
Z kompaktowymi nagłówkami obiektów:
OFF  SZ      TYPE DESCRIPTION                VALUE
 0   8           (object header: mark)     N/A
 8   8      long User.id                   N/A
16   4       int User.age                  N/A
20   1   boolean User.active               N/A
21   3           (object alignment gap)
Instance size: 24 bytes
Space losses: 0 bytes internal + 3 bytes external = 3 bytes total
Rozmiar obiektu spada z 32 do 24 bajtów.
Saved memory: 8 bytes
Reduction: 25%
Przykład 3: zmiana kolejności pól i dopełnienie
class Reordering {
   Reordering reordering;
   boolean enabled;
}

void main() {
   IO.print(ClassLayout.parseClass(Reordering.class).toPrintable());
}
Bez kompaktowych nagłówków obiektów:
OFF  SZ               TYPE DESCRIPTION                VALUE
 0   8                    (object header: mark)     N/A
 8   4                    (object header: class)    N/A
12   1            boolean Reordering.enabled        N/A
13   3                    (alignment/padding gap)
16   4   Main.Reordering Reordering.reordering     N/A
20   4                    (object alignment gap)
Instance size: 24 bytes
Space losses: 3 bytes internal + 4 bytes external = 7 bytes total
Z kompaktowymi nagłówkami obiektów:
OFF  SZ               TYPE DESCRIPTION                VALUE
 0   8                    (object header: mark)     N/A
 8   1            boolean Reordering.enabled        N/A
 9   3                    (alignment/padding gap)
12   4   Main.Reordering Reordering.reordering     N/A
Instance size: 16 bytes
Space losses: 3 bytes internal + 0 bytes external = 3 bytes total
Rozmiar obiektu spada z 24 do 16 bajtów.
Saved memory: 8 bytes
Reduction: 33.33%
Przykład 4: układ tablicy
void main() {
   IO.print(ClassLayout.parseInstance(new int[5]).toPrintable());
}
Bez kompaktowych nagłówków obiektów:
OFF  SZ   TYPE DESCRIPTION                VALUE
 0   8        (object header: mark)     0x0000000000000001
 8   4        (object header: class)    0x00184b48
12   4        (array length)             5
16  20    int [I.<elements>             N/A
36   4        (object alignment gap)
Instance size: 40 bytes
Space losses: 0 bytes internal + 4 bytes external = 4 bytes total
Z kompaktowymi nagłówkami obiektów:
OFF  SZ   TYPE DESCRIPTION                VALUE
 0   8        (object header: mark)     0x0018640000000001
 8   4        (array length)             5
12  20    int [I.<elements>             N/A
Instance size: 32 bytes
Space losses: 0 bytes internal + 0 bytes external = 0 bytes total
Rozmiar tablicy spada z 40 do 32 bajtów.
Saved memory: 8 bytes
Reduction: 20%
Podsumowanie i najważniejsze wnioski
Kompaktowe nagłówki obiektów przynoszą aplikacjom Java konkretne korzyści. Najbardziej widoczna z nich to mniejsze zużycie sterty. Zmniejszając nagłówek obiektu z 12/16 do 8 bajtów, HotSpot może zmniejszyć wiele obiektów, zwłaszcza małych, w których nagłówek stanowi dużą część całkowitego zużycia pamięci.
Korzyść nie dotyczy jednak wyłącznie pamięci. Mniejsze obiekty poprawiają też gęstość danych w pamięci. W tym samym obszarze sterty mieści się więcej obiektów, a w pamięci podręcznej CPU więcej danych. Poprawia to lokalność danych i może ograniczyć chybienia w pamięci podręcznej (cache misses), dzięki czemu CPU pracuje wydajniej.
Wymierne zyski na produkcji:
- OpenJDK: Pierwsi użytkownicy zaobserwowali zmniejszenie ilości żywych danych o około 10–20% w rzeczywistych aplikacjach.
Źródło: JEP 450 - Alibaba: Zgłoszono zmniejszenie zużycia pamięci o 5–10% i wzrost przepustowości nawet o 9% na platformie YiTian.
Źródło: Alibaba Cloud Blog - Amazon: Zgłoszono około 22% mniejsze zużycie sterty i 8–11% wyższą przepustowość.
Źródło: Lilliput FOSDEM 2025
-XX:+UseCompactObjectHeaders.
Jeśli chcesz zgłębić temat, gorąco polecam następujące materiały: