Witaj w drugiej części serii o budowie architektury kdb+ tick. W pierwszej części omówiliśmy kluczowe pojęcia i przeszliśmy przez kolejne komponenty – od tickerplantu, RDB, HDB i RTS po gateway i dalej.
Czas przełożyć teorię na praktykę: w tej części skonfigurujemy i uruchomimy od podstaw pełną architekturę kdb+ tick krok po kroku.
Konfiguracja środowiska kdb+/q
Zanim uruchomimy naszą architekturę tick, musimy przygotować kdb+ i q – zainstalować je i skonfigurować na swojej maszynie. Przejdź na stronę kx.com/kdb-personal-edition-download i pobierz darmową edycję osobistą.
Możesz też skorzystać z darmowego środowiska sandbox (JupyterLab) udostępnianego w KX Academy – bez żadnych wymagań wstępnych, wszystko działa w przeglądarce.
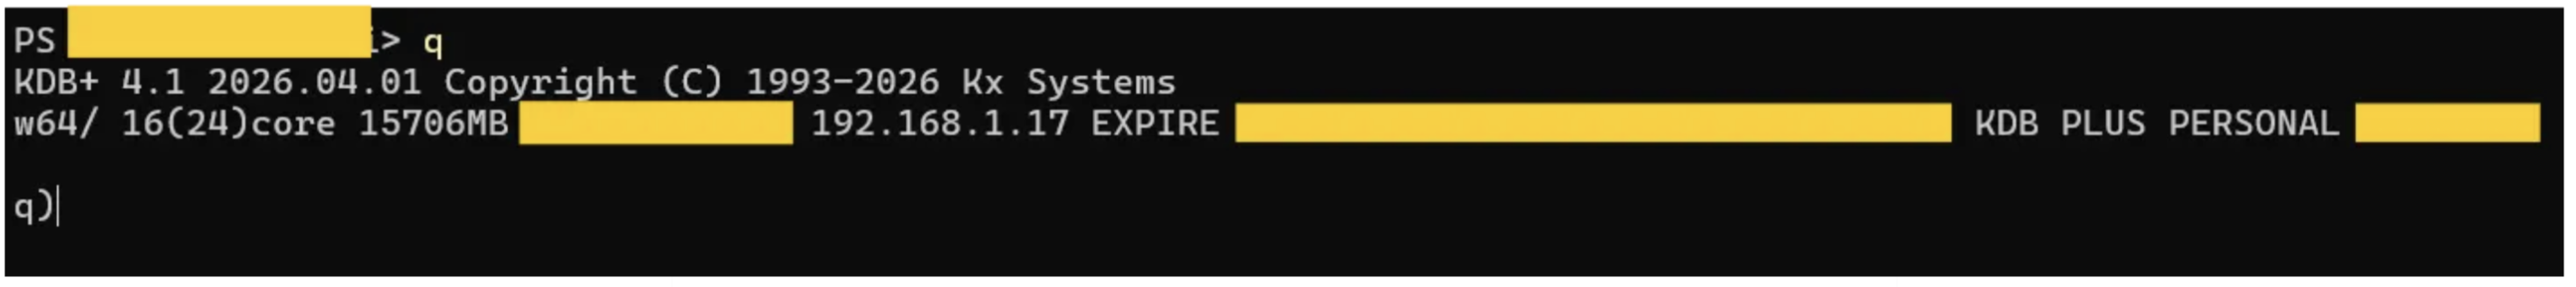
Po pobraniu i rozpakowaniu (np. do C:\q) skonfiguruj zmienne środowiskowe:
Ustaw QHOME:
setx QHOME "C:\q"
Dodaj do PATH:
setx PATH "%PATH%;C:\q\w64"
Klonowanie repozytorium git KxSystems
Sklonuj poniższe repozytorium, aby pobrać przykładowe skrypty architektury:
git clone https://github.com/KxSystems/kdb-architecture-course.git
Uruchomienie tickerplantu (TP)
Tickerplant to serce architektury. Uruchom go poleceniem:
q tick.q sym . -p 5010
Plik sym.q definiuje naszą tabelę trade:
trade:([]time:`timespan$();sym:`g#`symbol$();price:`float$();side:`symbol$())
Uruchomienie Real-Time Database (RDB)
RDB subskrybuje tickerplant i przechowuje dane z bieżącego dnia w pamięci. Uruchom go poleceniem:
q tick/rdb.q -p 5011
Uruchomienie feed handlera
Feed handler generuje dane i wysyła je do tickerplantu. Uruchom go poleceniem:
q tick/feed.q
Otwiera połączenie i co sekundę generuje losowe transakcje:
h_tp:hopen 5010;system"t 1000";
Uruchomienie Historical Database (HDB)
HDB udostępnia dane z dysku. Uruchom go poleceniem:
q tick/hdb.q sym -p 5012
Poniższe polecenie symuluje zdarzenie końca dnia (End-of-Day, EOD) – uruchom je w tickerplancie:
q).u.endofday[]
Uruchomienie Real-Time Subscriber (RTS)
RTS wykonuje własną logikę na przychodzących danych. Uruchom go poleceniem:
q tick/rts.q -p 5013
Przechowuje ostatnią cenę dla każdego symbolu:
latestSymPrice: `sym xkey 0#trade;`latestSymPrice upsert select by sym from d
Uruchomienie gatewaya
Gateway to pojedynczy punkt wejścia dla zapytań. Uruchom go poleceniem:
q tick/gw.q -p 5014
Kieruje zapytania jednocześnie do HDB i RDB:
h_hdb:hopen 5012; h_rdb:hopen 5011;hdb,rdb
Od teorii do praktyki z kdb+
Zbudowanie w pełni działającej architektury tick to ważny krok w opanowaniu kdb+. Łącząc tickerplant, RDB, HDB i gateway, masz teraz system zdolny obsłużyć cały cykl życia danych wysokiej częstotliwości.
Chcesz skalować swoją architekturę lub zintegrować ją z firmowym środowiskiem Java? Eksperci MARGO pomogą Ci zapanować nad złożonością inżynierii danych w czasie rzeczywistym.
Skontaktuj się z naszymi ekspertamiCzym jest QHOME i dlaczego jest niezbędne do konfiguracji?
QHOME to zmienna środowiskowa, która wskazuje systemowi kdb+, gdzie znajdują się jego podstawowe pliki i biblioteki. Bez niej interpreter q nie może załadować kluczowych funkcji ani skryptów potrzebnych do działania architektury tick.
Jak sprawdzić, czy subskrybent jest poprawnie połączony z tickerplantem?
Uruchom polecenie .u.w w procesie tickerplantu. Zwróci ono słownik z listą wszystkich aktywnych subskrybentów i tabel, które obserwują, np. RDB lub RTS.
Co dzieje się z danymi w RDB podczas zdarzenia końca dnia (End-of-Day, EOD)?
Podczas EOD tickerplant powiadamia RDB, aby zapisał wszystkie dane z pamięci na dysku jako nową partycję dzienną. Po zakończeniu zapisu RDB czyści swoje lokalne tabele i zaczyna kolejny dzień od zera.
Dlaczego kdb+ stosuje enumerację symboli w HDB?
Enumeracja symboli mapuje symbole (podobne do łańcuchów znaków) na liczby całkowite w pliku sym. Ta optymalizacja znacząco zmniejsza zużycie pamięci i przyspiesza zapytania na dużych zbiorach historycznych, bo eliminuje wielokrotne przechowywanie tych samych łańcuchów.
Czy gateway obsłuży jednocześnie zapytania o dane z dziś i z wczoraj?
Tak. Gateway kieruje jedno zapytanie zarówno do RDB (dane w czasie rzeczywistym), jak i do HDB (dane historyczne), a wyniki scala w jedną spójną odpowiedź dla użytkownika końcowego.