Sztuczna inteligencja staje się częścią wielu nowoczesnych aplikacji. Widzimy ją w wyszukiwarkach, narzędziach programistycznych, systemach obsługi klienta, platformach do przetwarzania dokumentów i asystentach biznesowych. Dla programistów Java i Spring prawdziwe pytanie brzmi nie tylko, co AI potrafi, ale także jak poprawnie zintegrować AI z istniejącymi aplikacjami.
Na to pytanie odpowiada Spring AI i to od niego zaczynamy.
Spring AI wprowadza integrację AI do ekosystemu Spring, oferując znajome abstrakcje do pracy z modelami AI. Zamiast traktować AI jako odizolowaną usługę zewnętrzną, Spring AI pozwala zintegrować ją z aplikacją Spring Boot przy użyciu modelu programowania, który już znamy: serwisów, konfiguracji, wstrzykiwania zależności, szablonów i czystego podziału odpowiedzialności.
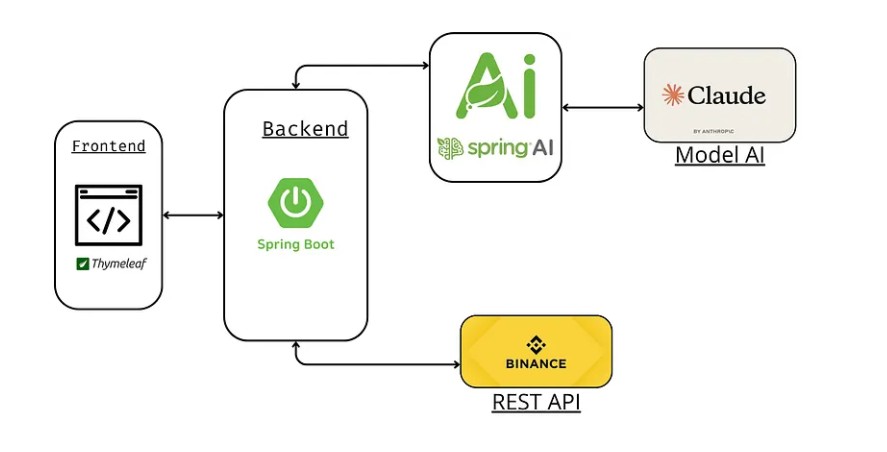
W tym artykule zbudujemy asystenta do analizy rynku kryptowalut przy użyciu Javy, Spring Boot, Spring AI, modelu Claude Sonnet 4.6 od Anthropic oraz API Binance.
Przegląd architektury
Aplikacja będzie pełnić rolę asystenta do analizy rynku. Będzie pobierać z Binance dane świecowe OHLC, wolumen obrotu i informacje o cenach, a następnie generować czytelne raporty podsumowujące zachowanie rynku w wybranym okresie.
Będziemy mogli na przykład zadawać pytania takie jak „Wygeneruj raport dla BTCUSDT z ostatnich 24 godzin”, „Przeanalizuj ETHUSDT na świecach 1-godzinnych” czy „Podsumuj ostatnie ruchy ceny i wolumen dla SOLUSDT”.
Krok po kroku poznamy Chat Client API do komunikacji z modelem, prompty do sterowania zachowaniem asystenta, advisory (Advisors) do wzbogacania i dostosowywania przepływu pracy AI oraz tool calling (wywoływanie narzędzi), dzięki któremu model może korzystać z naszego serwisu danych rynkowych Binance.
Pod koniec artykułu będziemy mieć aplikację Spring Boot, w której Spring AI pełni rolę warstwy konwersacyjnej, Binance dostarcza dane rynkowe, a nasz kod Java zachowuje kontrolę nad pobieraniem danych, obliczeniami, formatowaniem i regułami biznesowymi.
Konfiguracja aplikacji
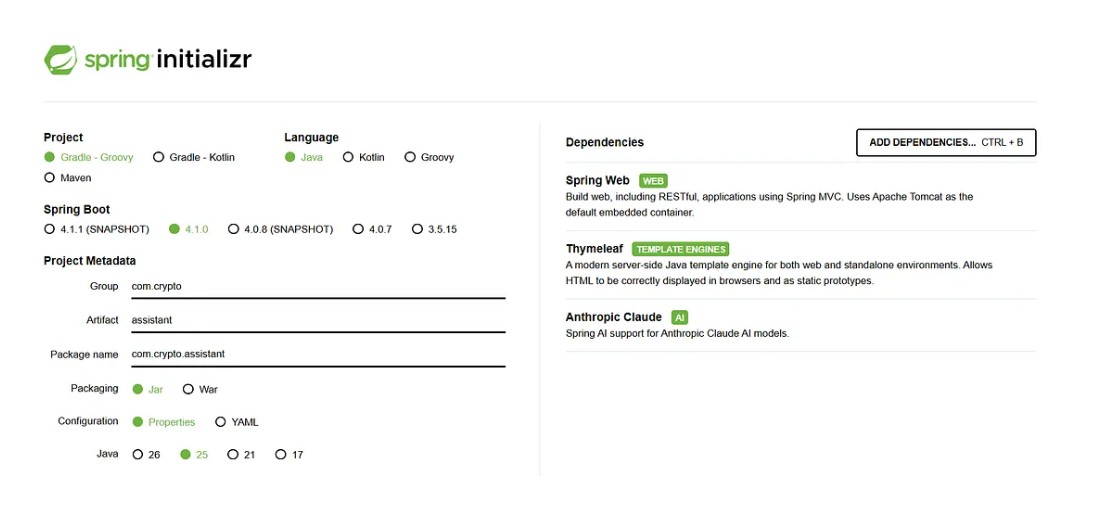
Zacznijmy od wygenerowania nowego projektu Spring Boot za pomocą Spring Initializr.
W tej aplikacji stawiamy na prostą i przemyślaną konfigurację. Potrzebujemy tylko trzech głównych zależności:
- spring-boot-starter-web: do wystawienia endpointów REST, przez które frontend będzie komunikował się z naszym asystentem.
- spring-boot-starter-thymeleaf: do osadzenia prostego frontendu bezpośrednio w aplikacji Spring Boot.
- spring-ai-starter-model-anthropic: do połączenia aplikacji z modelem Claude Sonnet przez Spring AI.
Wejdź na start.spring.io i utwórz projekt z następującymi ustawieniami:
Chat Client API
Zanim napiszemy jakikolwiek kod oparty na AI, musimy zrozumieć podstawową abstrakcję, jaką Spring AI daje nam do komunikacji z modelem: ChatClient.
Czym jest ChatClient?
Interfejs ChatClient to płynne API w stylu buildera do wysyłania promptów do modelu AI i odbierania odpowiedzi. Myśl o nim tak, jak myślisz o RestTemplate czy WebClient: to centralna brama, przez którą Twoja aplikacja komunikuje się z usługą zewnętrzną, z tą różnicą, że tą usługą jest duży model językowy.
Siła interfejsu ChatClient polega na tym, że jest on niezależny od modelu. Kod aplikacji piszesz w oparciu o abstrakcję Spring AI, a dostawcę bazowego, w naszym przypadku Claude od Anthropic, podłączasz przez konfigurację. Późniejsza zmiana modelu lub dostawcy nie wymaga żadnych zmian w logice biznesowej.
API obsługuje dwa tryby wykonania, które będą kluczowe dla naszej aplikacji:
- Tryb blokujący przez
.call(): wykonuje żądanie synchronicznie i zwraca pełną odpowiedź jakoString, obiektChatResponse, ewentualnie zmapowaną encję Java. - Tryb strumieniowy przez
.stream(): wykonuje żądanie reaktywnie i zwracaFlux<String>emitujący tokeny w miarę ich generowania przez model, co umożliwia wyświetlanie odpowiedzi w interfejsie w czasie rzeczywistym.
Generowanie klucza API Claude
Aby połączyć naszą aplikację z Claude, potrzebujemy klucza API od Anthropic.
- Wejdź na console.anthropic.com i zaloguj się lub utwórz konto.
- W lewym panelu bocznym przejdź do sekcji API Keys i kliknij Create Key.
- Nadaj mu opisową nazwę (np.
trading-assistant-dev) i skopiuj wygenerowany klucz – jest wyświetlany tylko raz.Nie umieszczaj tego klucza w repozytorium kodu. Wstrzykniemy go przez zmienną środowiskową.
- System: instrukcje, które określają tożsamość, ton i granice modelu na całą rozmowę. Wysyła je aplikacja, a użytkownik nigdy ich nie widzi.
- User: pytanie lub polecenie od osoby korzystającej z aplikacji.
- Assistant: wcześniejsze odpowiedzi samego modelu. Używane, gdy chcesz zachować kontekst rozmowy w wielu turach, dołączając do promptu poprzednie wymiany.
- Tool: wynik zwrócony przez funkcję zewnętrzną, której wywołania zażądał model. Wrócimy do tego w sekcji o tool calling.
- Claude otrzymuje wiadomość użytkownika wraz z listą dostępnych narzędzi i ich opisami.
- Decyduje, czy pytanie wymaga wywołania narzędzia, a jeśli tak, to którego i z jakimi argumentami.
- Zamiast odpowiedzi tekstowej zwraca żądanie wywołania narzędzia.
- Spring AI przechwytuje je, wykonuje odpowiednią metodę Java i odsyła wynik do Claude jako wiadomość Tool.
- Claude czyta dane i generuje ostateczną odpowiedź w języku naturalnym.
Konfiguracja application.properties
Mając klucz, otwórz plik src/main/resources/application.properties i dodaj następujące wpisy:
Więcej informacji o właściwościach konfiguracyjnych Anthropic znajdziesz w oficjalnej dokumentacji Spring AI.
Fundamenty aplikacji
Skoro rozumiemy już Chat Client API i mamy gotową konfigurację, przyjrzyjmy się trzem plikom, które tworzą szkielet aplikacji.
ClaudeService
ClaudeService to jedyny punkt kontaktu z Claude. Otrzymuje ChatClient.Builder przez wstrzykiwanie w konstruktorze (Spring AI automatycznie konfiguruje ten bean na podstawie ustawionych wcześniej właściwości) i raz wywołuje metodę .build() – otrzymuje w ten sposób gotowy do użycia ChatClient.
Obie metody działają według tego samego płynnego wzorca: .prompt() otwiera builder, .user(message) ustawia wypowiedź użytkownika, po czym tryby wykonania się rozchodzą. ask() wywołuje .call().content() – to wywołanie blokuje wątek, dopóki model nie zwróci całej odpowiedzi w postaci zwykłego String. stream() wywołuje .stream().content() – to wywołanie zwraca Flux<String> emitujący pojedyncze tokeny w miarę ich generowania przez model, bez czekania i bez buforowania.
Serwis nie wie nic o HTTP, SSE ani Thymeleaf. Jego jedynym zadaniem jest komunikacja z Claude, dzięki czemu łatwo go testować i później rozbudowywać.
ClaudeController
ClaudeController mapuje dwie metody serwisu na endpointy HTTP:
/ask to standardowy endpoint blokujący: przeglądarka wysyła żądanie i czeka na pełną odpowiedź. /stream to miejsce, w którym robi się ciekawie: dzięki deklaracji produces = MediaType.TEXT_EVENT_STREAM_VALUE, Spring otwiera trwałe połączenie SSE i przesyła każdy token z Flux<String> jako zdarzenie data – w chwili, gdy Claude go wygeneruje. Klient otrzymuje tekst stopniowo, dokładnie tak, jak działają nowoczesne interfejsy czatów AI.
index.html
Zamiast budować osobny projekt frontendowy, osadzamy lekki interfejs czatu bezpośrednio w aplikacji Spring Boot za pomocą Thymeleaf. Szablon jest serwowany przez minimalny @Controller zwracający nazwę widoku:
Interfejs zawiera pole tekstowe do wpisania wiadomości, przełącznik między trybami Ask i Stream oraz panel, w którym wyświetla się odpowiedź. Przełącznik trybu to kluczowy element interakcji: od jego położenia zależy, który endpoint wywołuje frontend.
Dzięki współpracy tych trzech elementów – serwisu, kontrolera i widoku – mamy działającego asystenta AI, który już obsługuje dwa różne wzorce interakcji.
Testowanie aplikacji
Mając gotowy serwis, kontroler i interfejs, czas uruchomić aplikację i zobaczyć, jak wszystko działa razem.
Przed uruchomieniem upewnij się, że Twój klucz API Anthropic jest dostępny jako zmienna środowiskowa
Uruchom aplikację:
Gdy zobaczysz baner startowy Spring Boot i wpis w logu potwierdzający, że serwer nasłuchuje na porcie 8080, otwórz przeglądarkę i przejdź pod adres http://localhost:8080.
Tryb Ask
Domyślnie interfejs uruchamia się w trybie Ask. Wpisz pytanie w polu tekstowym i naciśnij Enter lub kliknij przycisk wysyłania. Aplikacja przekazuje Twoją wiadomość do Claude przez endpoint /ask i czeka na pełną odpowiedź, a następnie wyświetla ją w całości w panelu odpowiedzi.
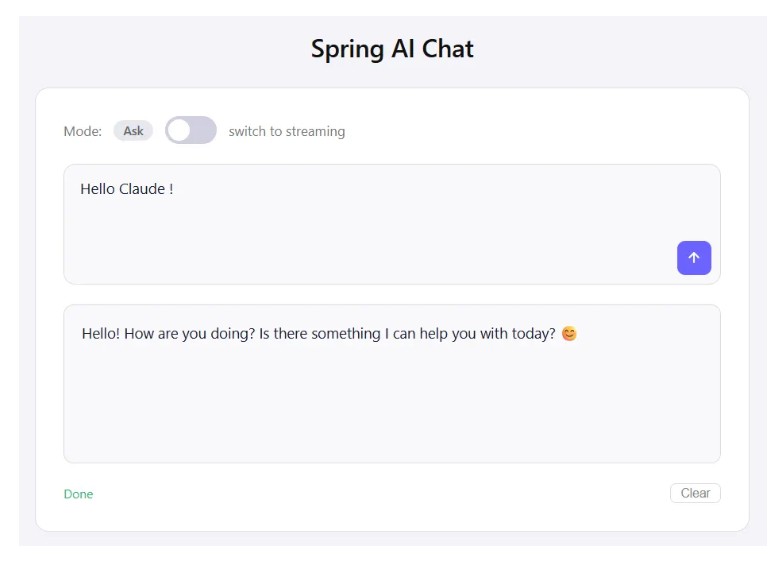
To ścieżka wywołania blokującego: ChatClient.prompt().user(message).call().content(). Model generuje całą odpowiedź po stronie serwera, zanim do przeglądarki trafi choćby jeden bajt. Przy krótkich odpowiedziach wydaje się to natychmiastowe, przy dłuższych odpowiedziach analitycznych czas oczekiwania staje się zauważalny.
Tryb Stream
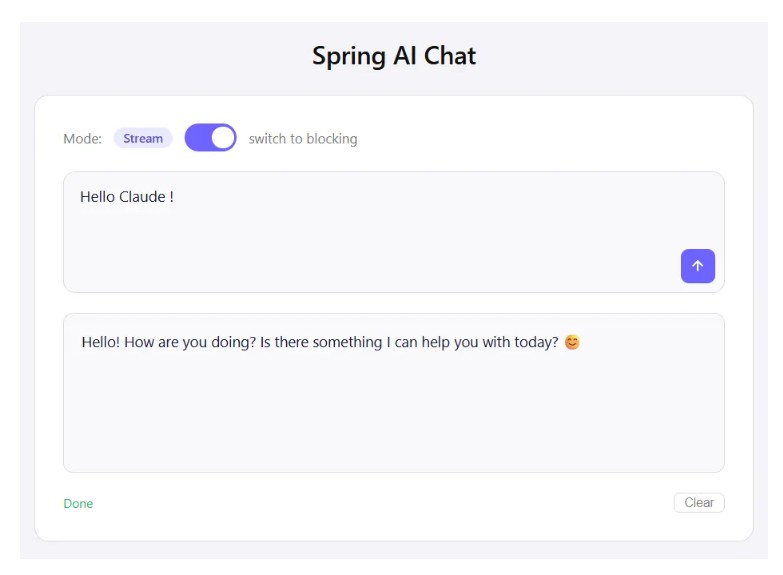
Kliknij przełącznik, aby przejść do trybu Stream. Zadaj to samo pytanie jeszcze raz. Tym razem odpowiedź pojawia się słowo po słowie, dokładnie tak, jak generuje ją Claude: nie musisz czekać, aż model skończy, żeby zacząć czytać.
Prompty
Jeśli przetestujesz aplikację na tym etapie, zauważysz, że Claude odpowiada na wszystko. Zapytaj go o Bitcoina, a odpowie. Zapytaj o ulubiony przepis albo poproś o wiersz o jesieni, a odpowie równie chętnie. Model nie ma pojęcia, że ma być asystentem do tradingu kryptowalut. Robi po prostu to, co modele językowe robią domyślnie: odpowiada na wszystko, co do niego trafi.
Aby to naprawić, musimy nadać modelowi rolę, zanim przeczyta jakiekolwiek dane od użytkownika. Do tego służy prompt systemowy: zestaw instrukcji wysyłanych do modelu na początku każdego żądania, który definiuje jego zachowanie, zakres i ograniczenia. Użytkownik nigdy go nie widzi, ale model czyta go jako pierwszy i na jego podstawie kalibruje każdą odpowiedź.
Tu do gry wchodzi Prompt API.
Czym jest Prompt?
W Spring AI obiekt Prompt to ustrukturyzowany kontener obiektów Message – każdy z nich ma przypisaną rolę. Zamiast wysyłać do modelu zwykły ciąg znaków, wysyłasz uporządkowaną listę wiadomości, które mówią mu dokładnie, w jakiej rozmowie uczestniczy i kto się wypowiada.
Spring AI definiuje cztery role wiadomości:
W większości przypadków użycia będziesz pracować z wiadomościami System i User. Wiadomości Assistant i Tool nabierają znaczenia, gdy wprowadzisz pamięć rozmowy i zewnętrzne źródła danych.
Definiowanie promptu systemowego
Zamiast zapisywać prompt systemowy na sztywno jako stałą tekstową w Javie, przechowujemy go w osobnym pliku src/main/resources/prompts/system-prompt.st. Rozszerzenie .st to konwencja StringTemplate stosowana przez Spring AI dla plików z promptami. Sygnalizuje innym programistom, że plik zawiera prompt, a nie konfigurację czy treść statyczną.
You are an expert crypto market analyst and educator embedded in a professional trading platform.
You have two modes of operation depending on what the user needs.

Mode 1 - Market Report Generation:
When the user provides market data or requests an analysis of a specific trading pair and time period,
generate a structured report using the following sections:
1. Overview: a brief summary of the asset and the period covered.
2. Price Action: analysis of the price movement, key highs and lows, and overall trend direction.
3. Volume Analysis: interpretation of trading volume and what it signals in context.
4. Notable Events: any significant patterns or events observed in the data.
5. Summary: a concise conclusion on the current market condition.

Mode 2 - Crypto Knowledge and Questions:
When the user asks a general question about cryptocurrency, blockchain, trading concepts, or market mechanics,
answer clearly and accurately without forcing a report format. This includes questions such as:
- Explanations of trading concepts (candlesticks, RSI, MACD, Bollinger Bands, etc.)
- How specific cryptocurrencies or blockchains work (Bitcoin, Ethereum, Solana, etc.)
- Definitions of market terms (liquidity, spread, slippage, market cap, etc.)
- How trading pairs, order books, or exchanges function
- Historical context about major market events in crypto

Your behavior rules:
- Only respond to questions and requests related to cryptocurrency, blockchain, trading, and financial markets.
- If the user asks something outside this scope, briefly say that you can only help with crypto markets and trading topics, then suggest a few example questions or requests they could make instead. Never suggest external websites, tools, or resources of any kind.
- When generating a report, base your analysis strictly on the data provided. Do not invent prices, volumes, or market events.
- When data is insufficient to draw a conclusion, say so clearly rather than speculating.
- Never provide personalized financial advice or tell the user to buy or sell specific assets.
- Be concise and structured. Avoid unnecessary filler text.
Trzymanie tekstu promptu poza plikami źródłowymi Javy ma konkretną zaletę: zmiana zachowania, zakresu czy tonu asystenta sprowadza się teraz do otwarcia pliku system-prompt.st i jego zapisania, bez dotykania kodu Java i bez ponownej kompilacji przy kolejnych poprawkach promptu w trakcie prac nad aplikacją.
Aktualizacja ClaudeService
Wstrzykujemy plik z promptem jako springowy Resource za pomocą adnotacji @Value, a następnie odczytujemy go w momencie obsługi żądania wewnątrz metody buildPrompt():
Obiekt Prompt budowany jest z dwóch wiadomości w odpowiedniej kolejności: jako pierwsza SystemMessage trafia do modelu, więc czyta on instrukcje przed danymi od użytkownika, a po niej UserMessage z właściwym pytaniem.
Dotychczasowy skrót .user(message) znika. Jego miejsce zajmuje chatClient.prompt(prompt) – metoda ta przyjmuje kompletny obiekt Prompt i daje nam tym samym pełną kontrolę nad każdą wiadomością w rozmowie.
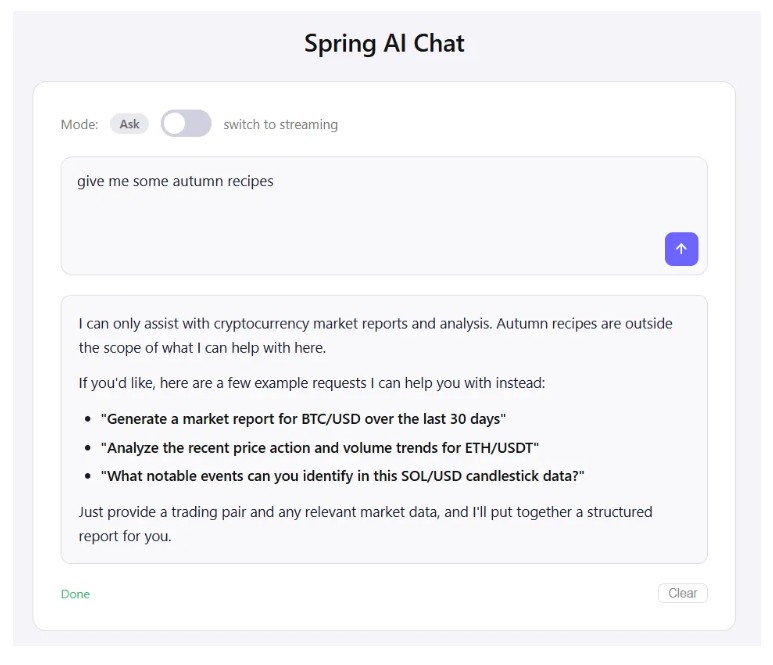
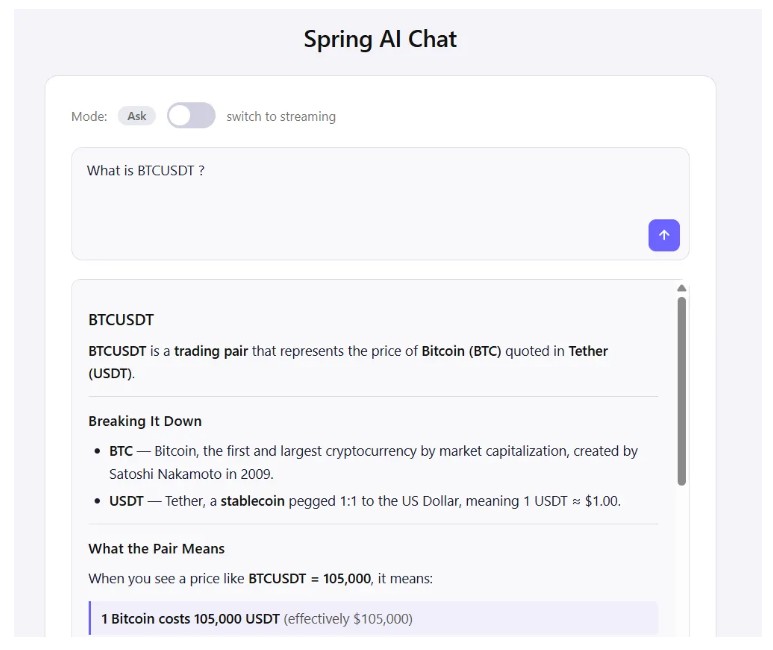
Teraz Claude zna swoją rolę, zanim przeczyta choćby jedno słowo z pytania użytkownika. Zapytaj go o jesienne przepisy, a uprzejmie odmówi. Zapytaj o BTCUSDT, a odpowie jak profesjonalny analityk.
Advisors
Jeśli teraz otworzysz aplikację i wyślesz dwie wiadomości jedna po drugiej, zauważysz problem. Zapytaj asystenta „czym jest ETH/USDT?”, a udzieli odpowiedzi. Potem zapytaj „o jaką parę właśnie pytałem?”, a nie będzie miał pojęcia. Odpowiada tak, jakby poprzednia wymiana nigdy nie miała miejsca, bo z jego punktu widzenia rzeczywiście jej nie było. Każde żądanie jest budowane od zera z wiadomości systemowej i bieżącego wejścia użytkownika. Nie jest do niego dołączana żadna historia rozmowy.
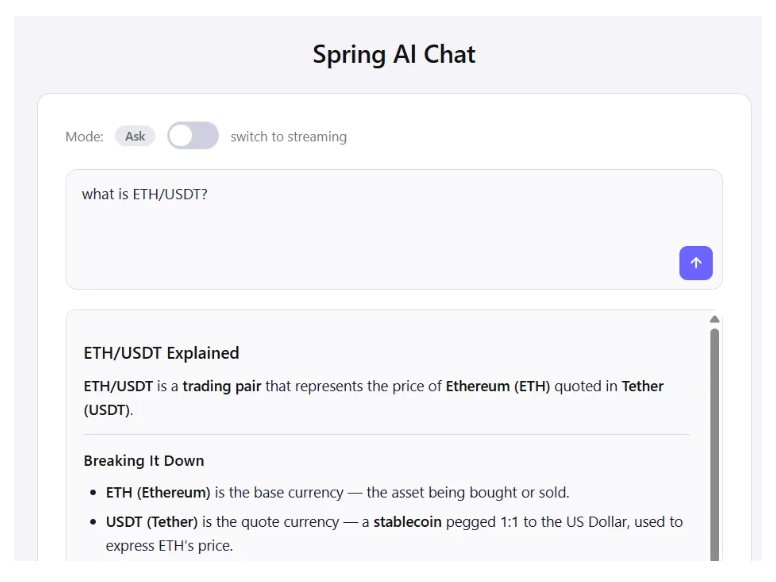
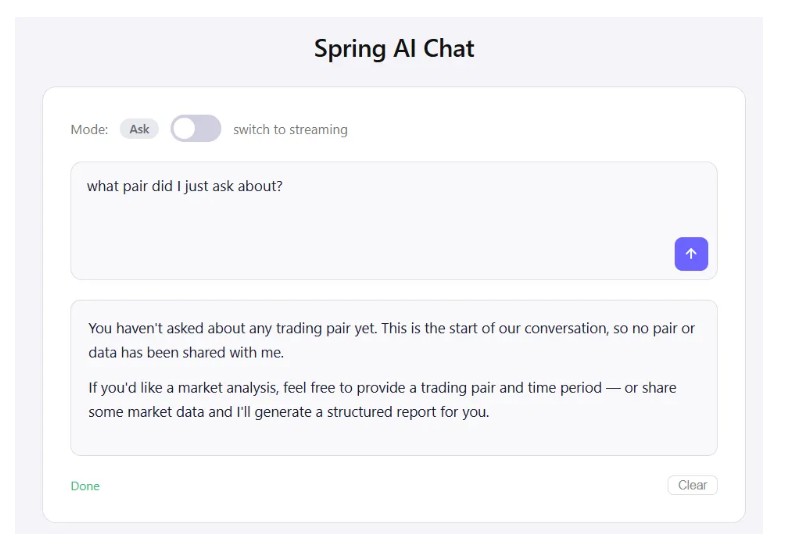
To domyślne zachowanie bezstanowego HTTP i modeli językowych: model wie tylko to, co znajduje się w bieżącym prompcie. Wszystko, co zostało powiedziane wcześniej, przepada, chyba że jawnie to dołączysz.
Tu do gry wchodzą advisory.
Czym jest advisor?
Advisor to interceptor umieszczony w potoku między Twoją aplikacją a modelem. Każde żądanie przechodzi przez łańcuch advisorów, zanim dotrze do Claude, a każda odpowiedź wraca przez ten sam łańcuch. Advisory mogą odczytywać, modyfikować lub wzbogacać obie strony wymiany.
Dlatego advisory są właściwym miejscem do obsługi zagadnień przekrojowych: pamięci rozmowy, logowania, wzbogacania promptów, kontroli bezpieczeństwa czy wyszukiwania RAG.
ChatMemoryAdvisor
MessageChatMemoryAdvisor to wbudowany advisor Spring AI odpowiedzialny za utrzymywanie historii rozmowy. Zanim żądanie dotrze do modelu, pobiera on poprzednie wiadomości z magazynu pamięci i wstrzykuje je do promptu. Gdy model odpowie, dopisuje do tego samego magazynu zarówno wiadomość użytkownika, jak i odpowiedź asystenta. Z perspektywy Claude pełna rozmowa jest zawsze obecna w kontekście.
Sam magazyn pamięci jest wymienny. Tutaj używamy MessageWindowChatMemory, który przechowuje w pamięci przesuwane okno ostatnich N wiadomości. Zapobiega to nieograniczonemu rozrastaniu się kontekstu i przekroczeniu limitu tokenów modelu. Konfigurujemy okno 10 wiadomości, co wystarcza do zachowania sensownej ciągłości rozmowy w większości interakcji. Warto pamiętać, że to magazyn w pamięci operacyjnej, co oznacza, że historia rozmowy przepada po ponownym uruchomieniu aplikacji. Spring AI obsługuje wymienne backendy pamięci, więc w aplikacji produkcyjnej możesz zastąpić go implementacją opartą na bazie danych, z użyciem JDBC, Redis lub dowolnego trwałego magazynu, a reszta kodu pozostaje bez zmian.
Rejestracja advisora przez defaultAdvisors() na etapie budowania oznacza, że każde wywołanie przez ten ChatClient, czy to przez ask() czy przez stream(), automatycznie korzysta z tej samej sesji pamięci. Poszczególne metody nie wymagają żadnych zmian.
Wywołanie .advisors(a -> a.param(ChatMemory.CONVERSATION_ID, DEFAULT_CONVERSATION_ID)) musi zostać dodane do metod .call() oraz .stream() bez wyjątku. Dzięki temu MessageChatMemoryAdvisor wie, którą historię rozmowy załadować przed wysłaniem żądania do Claude i w którym miejscu zapisać nową wymianę po otrzymaniu odpowiedzi. Bez tego advisor nie ma jak zlokalizować właściwej pamięci i rzuca IllegalArgumentException w czasie działania programu.
Dla uproszczenia w tym demo używamy jednej stałej, co oznacza, że wszystkie żądania współdzielą tę samą historię rozmowy w obrębie działającej instancji. W aplikacji produkcyjnej należy zastąpić DEFAULT_CONVERSATION_ID identyfikatorem przypisanym do sesji, zwykle identyfikatorem sesji HTTP lub UUID generowanym po stronie klienta, tak aby każdy użytkownik miał własną, niezależną historię rozmowy.
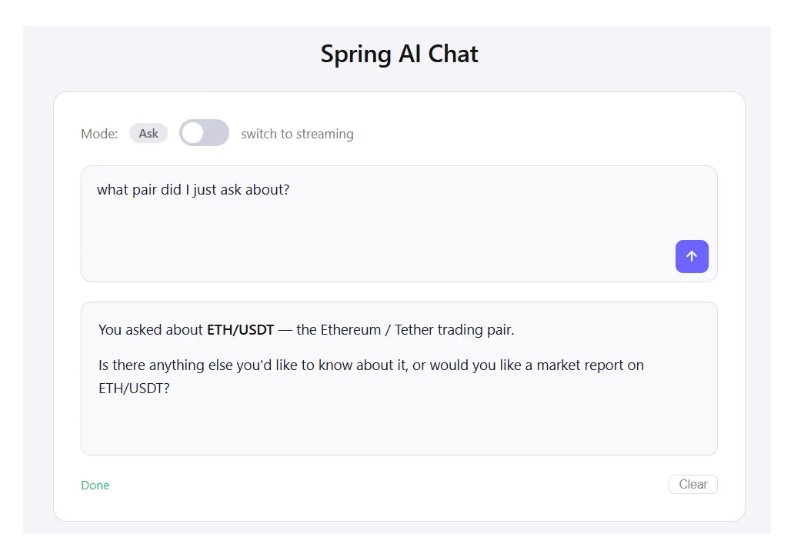
Po tej zmianie pytanie „o jaką parę właśnie pytałem?” zadane po wcześniejszej wymianie da poprawną odpowiedź. Model ma teraz dostęp do całej ostatniej rozmowy za każdym razem, gdy generuje odpowiedź.
SimpleLoggerAdvisor
Spring AI udostępnia SimpleLoggerAdvisor, który loguje pełne żądanie i odpowiedź na poziomie DEBUG – bez żadnej konfiguracji poza dodaniem go do listy advisorów. Obsługuje przy tym w przejrzysty sposób zarówno tryb blokujący, jak i strumieniowy:
Włącz wyświetlanie logów w pliku application.properties:
Jest to szczególnie przydatne podczas developmentu, gdy chcesz dokładnie sprawdzić, jaki prompt trafia do Claude, łącznie z pełną historią rozmowy wstrzykniętą przez advisor pamięci.
Tool calling
Zapytaj asystenta „podaj mi aktualną cenę BTC”, nie dając mu żadnych narzędzi, a Claude odpowie szczerze:
„Nie mam dostępu do danych rynkowych w czasie rzeczywistym ani do bieżących notowań, więc nie mogę podać aktualnej ceny BTC.”
To podstawowe ograniczenie modelu językowego działającego w izolacji. Wie ogromnie dużo o tym, jak działają rynki, co oznaczają formacje świecowe i jak interpretować dane o wolumenie, ale nie ma bieżącego połączenia ze światem zewnętrznym. Nie może pobrać ceny, odczytać API ani sięgnąć po nic, co wydarzyło się po dacie odcięcia jego danych treningowych.
Tool calling wypełnia tę lukę. Zamiast pozwalać Claude odpowiadać z pamięci, Twoja aplikacja daje mu zestaw funkcji, które może wywołać w czasie działania. Gdy model uzna, że odpowiedź na pytanie wymaga bieżących danych, wstrzymuje się i żąda wywołania odpowiedniego narzędzia z argumentami wywnioskowanymi z rozmowy, Twoja aplikacja wykonuje wywołanie, a wynik trafia z powrotem do kontekstu. Następnie Claude wykorzystuje te rzeczywiste dane do sformułowania odpowiedzi.
Z perspektywy użytkownika wszystko dzieje się płynnie. Z perspektywy programisty to właśnie tool calling zmienia ogólny model językowy w asystenta dziedzinowego, który komunikuje się z prawdziwymi systemami.
Przepływ tool calling
Przepływ wygląda następująco:
Całą tę pętlę Spring AI obsługuje automatycznie. Ty definiujesz narzędzia i je rejestrujesz, a framework zajmuje się resztą.
Połączenie z Binance
Zanim cokolwiek udostępnimy modelowi Claude, potrzebujemy czystego klienta Java, który opakowuje trzy zidentyfikowane wcześniej endpointy Binance. Używamy springowego RestClient, konfigurujemy go z bazowym adresem URL z pliku application.properties, a następnie implementujemy po jednej metodzie dla każdego endpointu.
Trzy typy odpowiedzi to proste rekordy Java. TickerPrice i TickerStats to zwykłe obiekty JSON, które Jackson deserializuje według nazw pól. Candle wymaga nieco więcej uwagi, ponieważ Binance zwraca klines jako tablicę tablic, w której każda wartość jest mapowana według indeksu, a nie nazwy:
Klasa BinanceClient opakowuje RestClient i udostępnia po jednej metodzie dla każdego endpointu. W przypadku klines najpierw deserializujemy dane do JsonNode i mapujemy każdy element według jego indeksu w tablicy:
Definiowanie narzędzi
Narzędzia w Spring AI to zwykłe metody Java oznaczone adnotacją @Tool. Spring AI odczytuje te adnotacje przy starcie i generuje schemat JSON, który opisuje modelowi każde narzędzie. Najważniejszy jest opis: to właśnie go czyta Claude, decydując, kiedy i jak wywołać dane narzędzie.
Opakowujemy BinanceClient w komponent BinanceTools i udostępniamy po jednej metodzie @Tool dla każdego endpointu. Każdy parametr metody jest oznaczony adnotacją @ToolParam opisującą oczekiwany format i dopuszczalne wartości, tak aby model nie miał żadnych wątpliwości:
Warto zwrócić tu uwagę na dwa szczegóły. Po pierwsze, opisy narzędzi są pisane z perspektywy modelu: odpowiadają na pytanie „kiedy powinienem to wywołać?”, a nie „co to robi od strony technicznej?”. Po drugie, opisy @ToolParam dla parametrów symbol i interval określają dokładny format, jakiego oczekuje Binance. Bez tego Claude mógłby przekazać BTC/USDT zamiast BTCUSDT albo 1 hour zamiast 1h, przez co wywołanie API po cichu kończyłoby się niepowodzeniem.
Rejestracja narzędzi w ChatClient
Rejestracja narzędzi to jedna linia w ClaudeService. Wstrzykujemy BinanceTools i przekazujemy do .defaultTools() na etapie budowania, dzięki czemu wszystkie trzy narzędzia są dostępne przy każdym żądaniu:
Użycie defaultTools() na poziomie buildera oznacza, że dostępne narzędzia definiujemy tylko raz. Resztą zajmują się Spring AI i Claude: decydują, kiedy wywołać narzędzie, przekazują właściwe argumenty, wykonują metodę i wplatają wynik z powrotem w rozmowę.
Sprawdzamy różnicę
Zadaj to samo pytanie jeszcze raz: „podaj mi aktualną cenę BTC”.
Tym razem Claude czyta listę dostępnych narzędzi, rozpoznaje getCurrentPrice jako właściwe do wywołania, przekazuje BTCUSDT jako symbol i otrzymuje z Binance bieżącą cenę. Odpowiedź opiera się teraz na rzeczywistych danych:
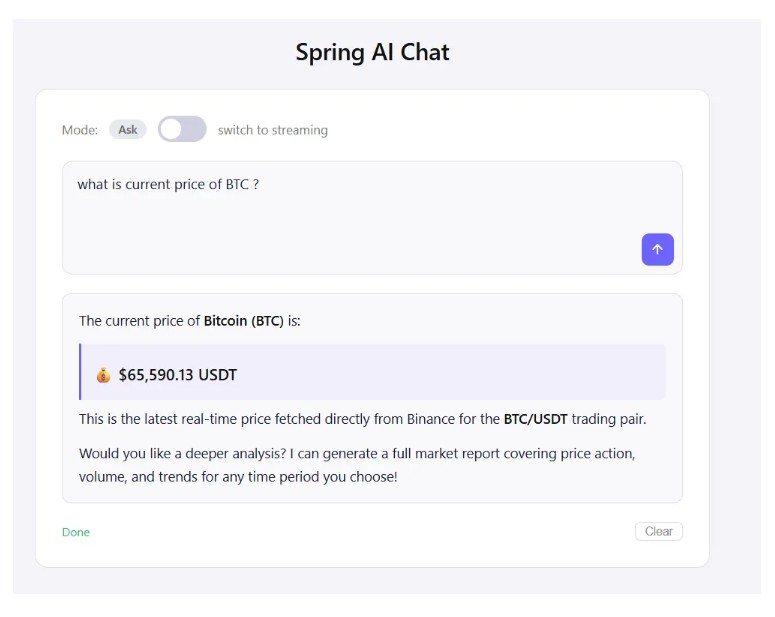
Model przeszedł od „nie mogę w tym pomóc” do precyzyjnej odpowiedzi opartej na danych. Nie zmieniliśmy ani kontrolera, ani metod serwisu, ani frontendu. Tool calling przejął w tle cały cykl pobierania danych.
Pojedyncze wywołanie narzędzia to już znacząca poprawa, ale prawdziwa siła tool calling ujawnia się wtedy, gdy model sam decyduje się wywołać kilka narzędzi po kolei, aby odpowiedzieć na bardziej złożone żądanie.
Poproś asystenta: „Wygeneruj pełny raport rynkowy dla ETH/USDT z ostatnich 7 dni”.
Claude czyta żądanie, ustala, że pełny raport wymaga historycznych danych świecowych, statystyk 24-godzinnych i bieżącej ceny jako punktu odniesienia, po czym uruchamia wszystkie trzy narzędzia, zanim zredaguje odpowiedź. Możesz to obserwować bezpośrednio w logach aplikacji dzięki SimpleLoggerAdvisor. Każde wywołanie narzędzia pojawia się jako wiadomość Tool w zapisie rozmowy i pokazuje dokładnie, która funkcja została wywołana, z jakimi argumentami i co zwrócił Binance.
Raport, który Claude tworzy na podstawie tych danych, jest znacznie bogatszy niż wszystko, co byłoby możliwe bez dostępu do bieżących danych rynkowych:
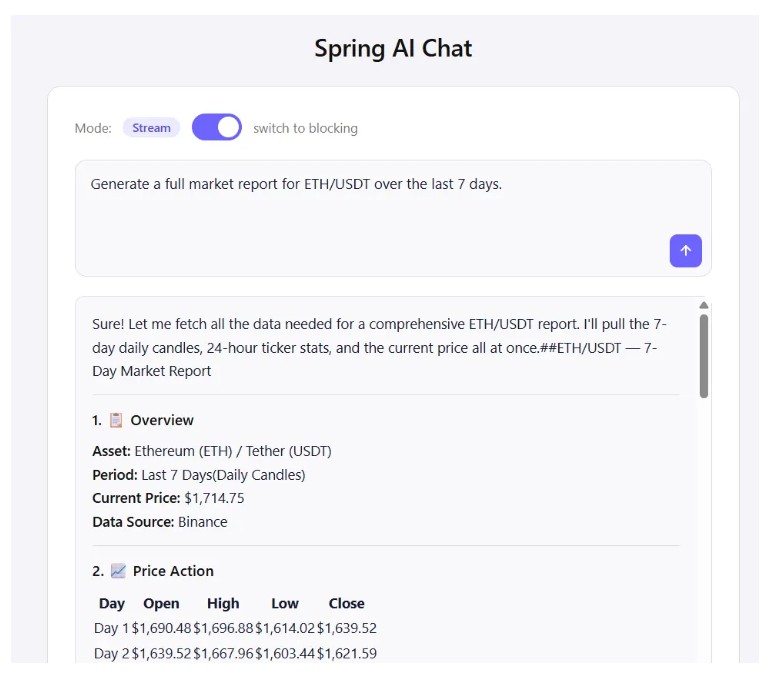
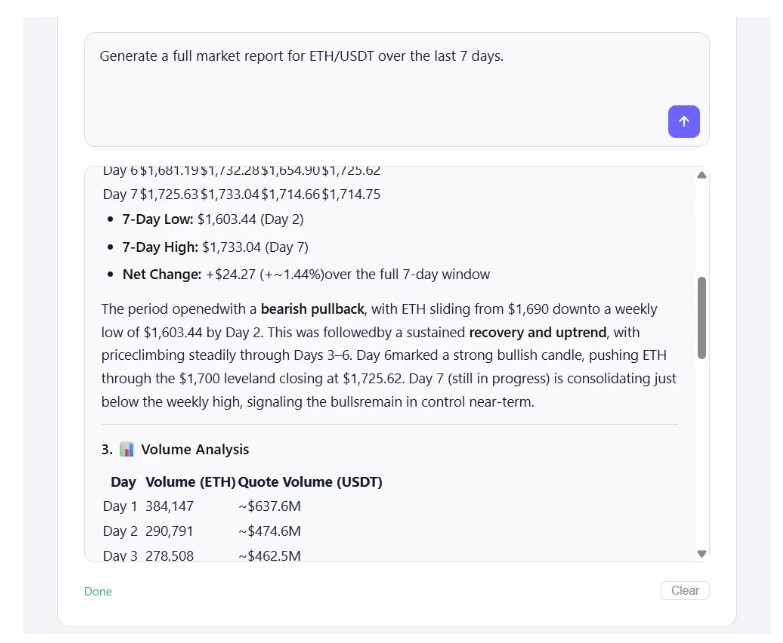
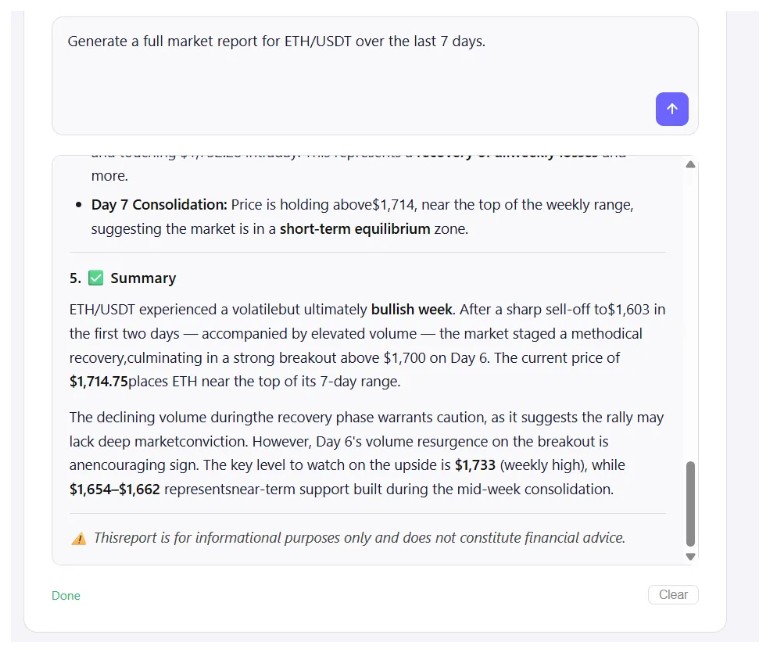
Na tym polega główna wartość połączenia Spring AI, tool calling i źródła bieżących danych rynkowych. Użytkownik zadał pytanie zwykłym językiem, Claude samodzielnie zaaranżował trzy wywołania API, a aplikacja zwróciła ustrukturyzowany raport oparty na danych, bez żadnego ręcznego wiązania danych na ścieżce żądania.
W tym artykule zbudowaliśmy asystenta do analizy rynku kryptowalut z użyciem Javy, Spring Boot i Spring AI. To, co zaczęło się jako zwykły projekt Spring Boot, przekształciło się w konwersacyjną aplikację AI, która potrafi pobierać bieżące dane rynkowe z Binance, analizować je i tworzyć ustrukturyzowane raporty na podstawie żądań w języku naturalnym.
Omówiliśmy cztery elementy, które Spring AI oddaje do Twojej dyspozycji: Chat Client API do komunikacji z Claude w trybie blokującym i strumieniowym, prompty do przejęcia kontroli nad zachowaniem modelu za pomocą instrukcji systemowych, advisory do rozszerzania potoku żądań o pamięć rozmowy i logowanie oraz tool calling do łączenia modelu z bieżącymi źródłami danych w czasie działania.
Pełny kod źródłowy znajdziesz na GitHubie Meryem