Kręgosłup nowoczesnych architektur danych
W ekosystemie technologicznym, w którym szybkość reakcji stała się strategicznym imperatywem, liderów rynku wyróżnia zdolność do natychmiastowego przetwarzania informacji. Apache Kafka stała się fundamentem tej rewolucji i zmieniła sposób, w jaki firmy projektują przepływ danych. Ten rozproszony system streamingowy, pierwotnie stworzony przez inżynierów LinkedIn, by poradzić sobie z nierozwiązywalnymi wcześniej problemami skalowalności, wyrósł ponad swoją pierwotną rolę i stał się standardem referencyjnym dla współczesnych infrastruktur.
Dziś wdrożenie Kafki to nie tylko odpowiedź na techniczną potrzebę przesyłania komunikatów: to przejście na architektury sterowane zdarzeniami, które w czasie rzeczywistym dostosowują się do wahań aktywności. Oferując solidną, odporną i wysoce rozszerzalną infrastrukturę, Kafka godzi wymagania wydajnościowe świata operacyjnego z potrzebami pogłębionej analizy big data. W tym artykule wyjaśniamy podstawowe mechanizmy, które czynią z Kafki filar nowoczesnego zarządzania danymi, i pokazujemy, jak wpisuje się ona w samo serce najbardziej ambitnych planów rozwoju IT.
Czym jest Kafka?
Apache Kafka to coś więcej niż zwykłe narzędzie do przesyłania danych: to kompletna platforma rozproszona, której możliwości opierają się na czterech filarach:
- Przesyłanie komunikatów: zapewnia płynną i bezpieczną dystrybucję komunikatów między heterogenicznymi systemami;
- Zarządzanie danymi w czasie rzeczywistym: umożliwia natychmiastowe przetwarzanie strumieni informacji, gdy tylko się pojawią;
- Trwałe przechowywanie: gwarantuje integralność i długoterminowe przechowywanie zdarzeń;
- Skalowalność: zapewnia skalowanie horyzontalne niezbędne w infrastrukturach o dużej skali.
W przeciwieństwie do tradycyjnych middleware’ów komunikacyjnych, takich jak RabbitMQ czy ActiveMQ, Kafka została zaprojektowana specjalnie z myślą o obsłudze ogromnych wolumenów danych przy zachowaniu bardzo niskich opóźnień i pełnej odporności na awarie.
Można ją postrzegać jako wysokowydajny potok danych, zdolny do przesyłania milionów zdarzeń na sekundę między krytycznymi aplikacjami.
Konkretny przykład: liderzy branży mobilności
W firmach takich jak Uber czy Bolt każda cyfrowa interakcja – zmiana pozycji GPS, transakcja finansowa czy wycena przejazdu – musi przejść przez Kafkę. Dzięki tej centralizacji wewnętrzne usługi mogą wykorzystywać te dane do:
- Wizualizacji: dynamicznego wyświetlania mapy w czasie rzeczywistym;
- Optymalizacji cen: natychmiastowego wyliczania ceny przejazdu;
- Bezpieczeństwa: wykrywania i blokowania prób oszustw;
- Analityki decyzyjnej: aktualizacji statystycznych wskaźników efektywności. Kafka działa tu jak centralny układ nerwowy, który spina wszystkie przepływy informacji w firmie.
Architektura techniczna: podstawowe pojęcia
Aby zrozumieć siłę Kafki, trzeba przyjrzeć się technologicznym elementom, które tworzą jej ekosystem:
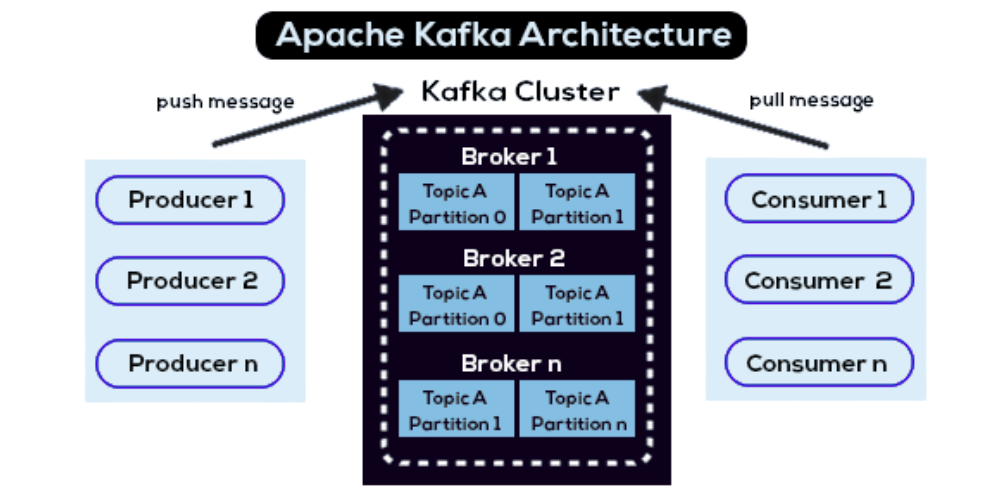
- Producenci (producers): odpowiadają za emitowanie i wprowadzanie komunikatów (zdarzeń) do odpowiednich topików w klastrze.
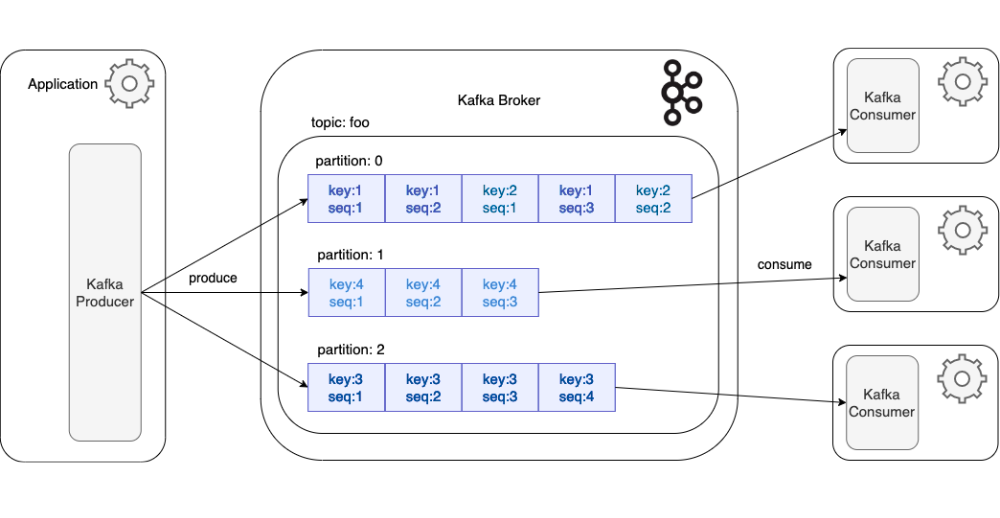
- Topiki (topics): logiczne kategorie, w których klasyfikowane są komunikaty. Aby zapewnić równoległość i skalowalność, każdy topik dzieli się na partycje.
- Brokery: fizyczne lub wirtualne serwery tworzące klaster Kafka. Ich zadaniem jest przechowywanie danych i obsługa żądań klientów.
- Konsumenci (consumers): aplikacje klienckie, które subskrybują topiki, aby odczytywać dane. Dla większej elastyczności można je grupować w „consumer groups”, które inteligentnie rozkładają obciążenie odczytu.
- Kafka Connect i Kafka Streams: pierwszy ułatwia zautomatyzowaną integrację z systemami zewnętrznymi (ETL, bazy danych), a drugi pozwala przekształcać i analizować strumienie w czasie rzeczywistym, bezpośrednio u źródła.
Dlaczego Kafka stała się fundamentem świata danych?
Popularność Apache Kafka wynika z cech technicznych, które spełniają najbardziej rygorystyczne wymagania działów IT:
Niezrównana wydajność i trwałe przechowywanie
Dzięki inteligentnemu partycjonowaniu i rozproszeniu na wiele brokerów Kafka przetwarza miliony zdarzeń na sekundę bez utraty szybkości. W przeciwieństwie do klasycznych kolejek, które usuwają komunikaty po odczycie, Kafka zapisuje je na dysku. Ta trwałość pozwala dowolnie odtwarzać historię strumienia, co jest ogromnym atutem przy synchronizacji mikroserwisów czy odtwarzaniu stanów analitycznych.
Katalizator elastyczności „event-driven”
Kafka sprzyja wydajnej architekturze mikroserwisów, ponieważ zapewnia:
- Ścisłe rozdzielenie: usługi komunikują się bez bezpośrednich zależności;
- Pełną asynchroniczność: procesy nie muszą czekać na natychmiastową odpowiedź, aby kontynuować pracę;
- Wbudowaną odporność: platforma zapewnia automatyczne odtwarzanie i ciągłość działania usług, eliminując ryzyko utraty danych.
Kafka w nowoczesnych ekosystemach
Apache Kafka, uznawana za centralny szkielet infrastruktury technologicznej („data backbone”), wykracza poza rolę zwykłego przekaźnika komunikatów i staje się układem nerwowym organizacji. Pełni kilka krytycznych funkcji, które porządkują nowoczesne ekosystemy.
Uniwersalna platforma strumieniowania zdarzeń
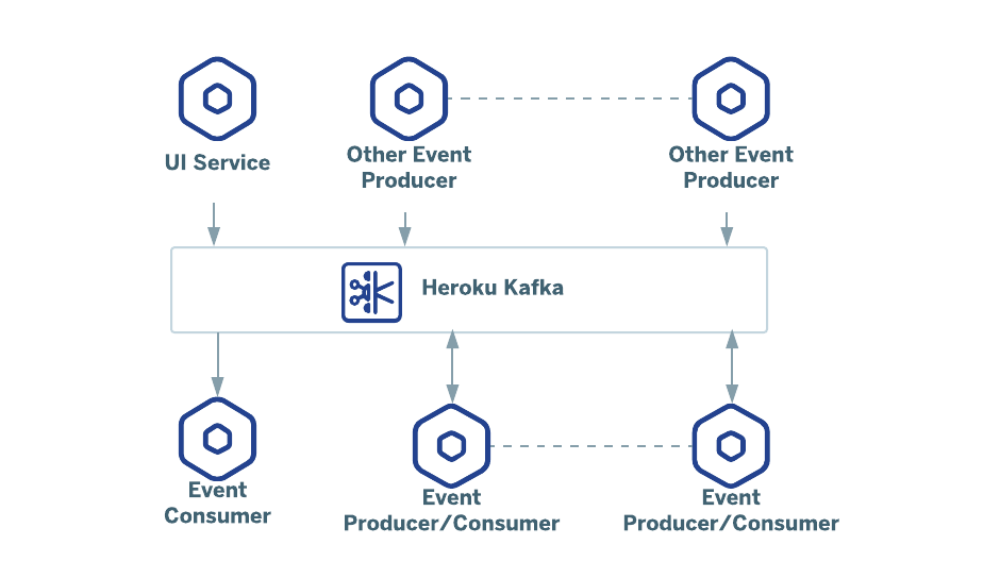
Kafka to platforma streamingowa, która centralizuje strumienie informacji z wielu heterogenicznych źródeł. Zamiast mnożyć połączenia punkt-punkt, narzędzie gromadzi dane w ujednolicony sposób i w czasie rzeczywistym przekazuje je wszystkim aplikacjom, które z nich korzystają. Ta zdolność agregacji likwiduje silosy danych i zapewnia płynny, natychmiastowy przepływ informacji w całej firmie.
Uprzywilejowany węzeł komunikacji dla mikroserwisów
W architekturach rozproszonych Kafka radykalnie zmienia komunikację między usługami. Zastępując bezpośrednie, synchroniczne wywołania API modelem publikowania zdarzeń, zapewnia pełne rozdzielenie usług.
Takie podejście nie tylko poprawia obserwowalność systemu, ale też umożliwia niespotykaną dotąd skalowalność horyzontalną: każda usługa może się rozwijać, zatrzymywać lub uruchamiać ponownie niezależnie, bez wpływu na stabilność całego łańcucha.
Strategiczny kanał ingestii danych dla big data i chmury
Dzięki ekosystemowi Kafka Connect platforma działa jak uniwersalny kanał ingestii dla środowisk masowego przechowywania danych. W sposób ciągły i automatyczny zasila Data Lakes, takie jak S3 czy Google Cloud Storage, a także nowoczesne hurtownie danych, takie jak Snowflake czy BigQuery.
Ta natywna integracja świata transakcyjnego i analitycznego przyspiesza udostępnianie danych na potrzeby Business Intelligence i data science.
Silnik przekształcania i analizy w czasie rzeczywistym
Poza transportem Kafka oferuje rozbudowane możliwości przetwarzania dzięki Kafka Streams i ksqlDB. Nie chodzi już tylko o przenoszenie danych, ale o ich przekształcanie w trakcie przesyłu. Firmy mogą w ten sposób wykonywać złożone operacje, takie jak łączenie strumieni, agregacje statystyczne czy wykrywanie krytycznych anomalii w precyzyjnych oknach czasowych, bez konieczności wdrażania ciężkich i kosztownych potoków ETL.
Rozproszone źródło prawdy do archiwizacji historii
Jedną z największych zalet Kafki jest możliwość przechowywania logów zdarzeń przez bardzo długi czas, a nawet bezterminowo. Dzięki temu platformę można wykorzystywać jako rozproszone „źródło prawdy”. W razie incydentu technicznego ta niezmienna pamięć pozwala odtworzyć pełną historię strumienia i odbudować dokładny stan mikroserwisu, co gwarantuje odporność i integralność danych niezbędne w działalności biznesowej.
Centralny węzeł między światem operacyjnym a analitycznym
Kafka pełni wreszcie rolę centralnego punktu, który łączy często odizolowane od siebie światy: systemy przetwarzania transakcyjnego (OLTP), platformy analityczne (OLAP), uczenie maszynowe i mikroserwisy. Jako jedyny punkt przepływu usprawnia wymianę danych i pozwala każdemu elementowi systemu informatycznego korzystać z danych zawsze aktualnych, wiarygodnych i spójnych.
Podsumowanie
Apache Kafka stała się kluczowym narzędziem współczesnych architektur danych. Jej zdolność do industrializacji ingestii, przechowywania i dystrybucji danych na masową skalę zapewnia solidny i elastyczny model komunikacji. Niezależnie od tego, czy chodzi o streaming, czy o integrację złożonych systemów, pozostaje najlepszą odpowiedzią na wyzwania czasu rzeczywistego.
👉 Skorzystaj z wiedzy naszych konsultantówNa czym polega podstawowa różnica między Kafką a tradycyjnym brokerem komunikatów, takim jak RabbitMQ?
Główna różnica dotyczy zarządzania danymi i skalowalności: klasyczny broker, taki jak RabbitMQ, zazwyczaj usuwa komunikaty po ich odebraniu, a Kafka trwale zapisuje je na dysku. Dzięki tej architekturze Kafka obsługuje ogromne wolumeny danych przy minimalnych opóźnieniach i pozwala odtwarzać strumienie zdarzeń, czego tradycyjne systemy komunikatów nie oferują.
Dlaczego partycje mają tak duże znaczenie dla wydajności?
Partycjonowanie napędza skalowalność horyzontalną Kafki: dzieląc każdy topik na kilka partycji rozmieszczonych na różnych brokerach, Kafka pozwala zrównoleglić odczyt i zapis danych. To właśnie ten mechanizm umożliwia przetwarzanie milionów komunikatów na sekundę i gwarantuje, że system może się skalować bez przeciążenia.
Czy Kafka naprawdę gwarantuje, że żadne dane nie zostaną utracone?
Tak, dzięki modelowi trwałego przechowywania i rozproszonej architekturze: w przeciwieństwie do systemów ulotnych Kafka przechowuje komunikaty w sposób trwały. W razie awarii usługi lub brokera platforma zapewnia automatyczne odtwarzanie i ciągłość działania, co czyni ją wiarygodnym źródłem prawdy dla krytycznych architektur.
Czy można przekształcać dane w Kafce bez narzędzi zewnętrznych?
Oczywiście, właśnie do tego służą Kafka Streams i ksqlDB: te zintegrowane narzędzia pozwalają filtrować, przekształcać, wzbogacać i agregować strumienie danych bezpośrednio w platformie. Nie trzeba wdrażać ciężkich, zewnętrznych potoków ETL, a metryki i krytyczne zdarzenia można generować i wykrywać w czasie rzeczywistym.
Jak Kafka integruje się z istniejącą infrastrukturą chmurową i big data?
Kafka działa jak uniwersalny kanał ingestii dzięki Kafka Connect: może pobierać dane z wielu źródeł lub wysyłać je do wielu miejsc docelowych, takich jak Data Lakes (S3, GCS) czy nowoczesne hurtownie danych (Snowflake, BigQuery). Staje się w ten sposób centralnym punktem, który łączy systemy transakcyjne, analitykę i uczenie maszynowe.