Learning Expedition na CppCon 2026 dla MARGO: po powrocie z największego światowego zgromadzenia C++ w Kolorado, zapraszamy do zapoznania się z naszą analizą najważniejszych prelekcji oraz podsumowaniem wystąpienia Lightning Talk zaprezentowanego przez Louise Kraffe na arenie międzynarodowej.
MARGO na CppCon 2026: w samym sercu największego światowego zgromadzenia C++
Co roku w Stanach Zjednoczonych CppCon umacnia swoją pozycję jako absolutny punkt odniesienia wśród konferencji poświęconych językowi C++. Przez cały pełny tydzień gromadzi się tam ponad tysiąc deweloperów, architektów oprogramowania i twórców narzędzi. W istocie to kluczowe wydarzenie pozwala kształtować przyszłość języka i wymieniać doświadczenia na temat architektur systemowych poddanych silnym rygorom wydajnościowym.
CppCon 2026: doskonałość C++ w Learning Expedition
Systemy wbudowane, trading wysokich częstotliwości (high-frequency trading), robotyka czy infrastruktury AI: CppCon obejmuje pełen zakres dziedzin, w których surowa wydajność i niska latencja (low latency) są krytyczne.
ekspertów & uczestników
sesje & warsztaty
technicznej immersji
Z jednej strony utrzymanie poziomu doskonałości wymaga obecności tam, gdzie decyduje się przyszłość technologii. Z drugiej strony organizacja naszych Learning Expeditions poprzez nasz EXCELLENCE Hub odpowiada jasnemu celowi: konfrontacji naszych ekspertów z najlepszymi specjalistami na świecie. Ponadto wnosimy tę wartość dodaną bezpośrednio do samego serca krytycznych projektów naszych klientów.
To właśnie w tej dynamice Louise Kraffe reprezentowała nasze zespoły w Kolorado. Oprócz uczestnictwa w konferencjach wystąpiła na scenie podczas Lightning Talk. Jej wystąpienie było poświęcone strukturom danych low latency z prezentacją algorytmu HAMT (Hash Array Mapped Trie).
CppCon 2026: podsumowanie techniczne konferencji C++
1. Processor Design and C++ Memory Models
Ofek Shilon — Podsumowanie techniczne
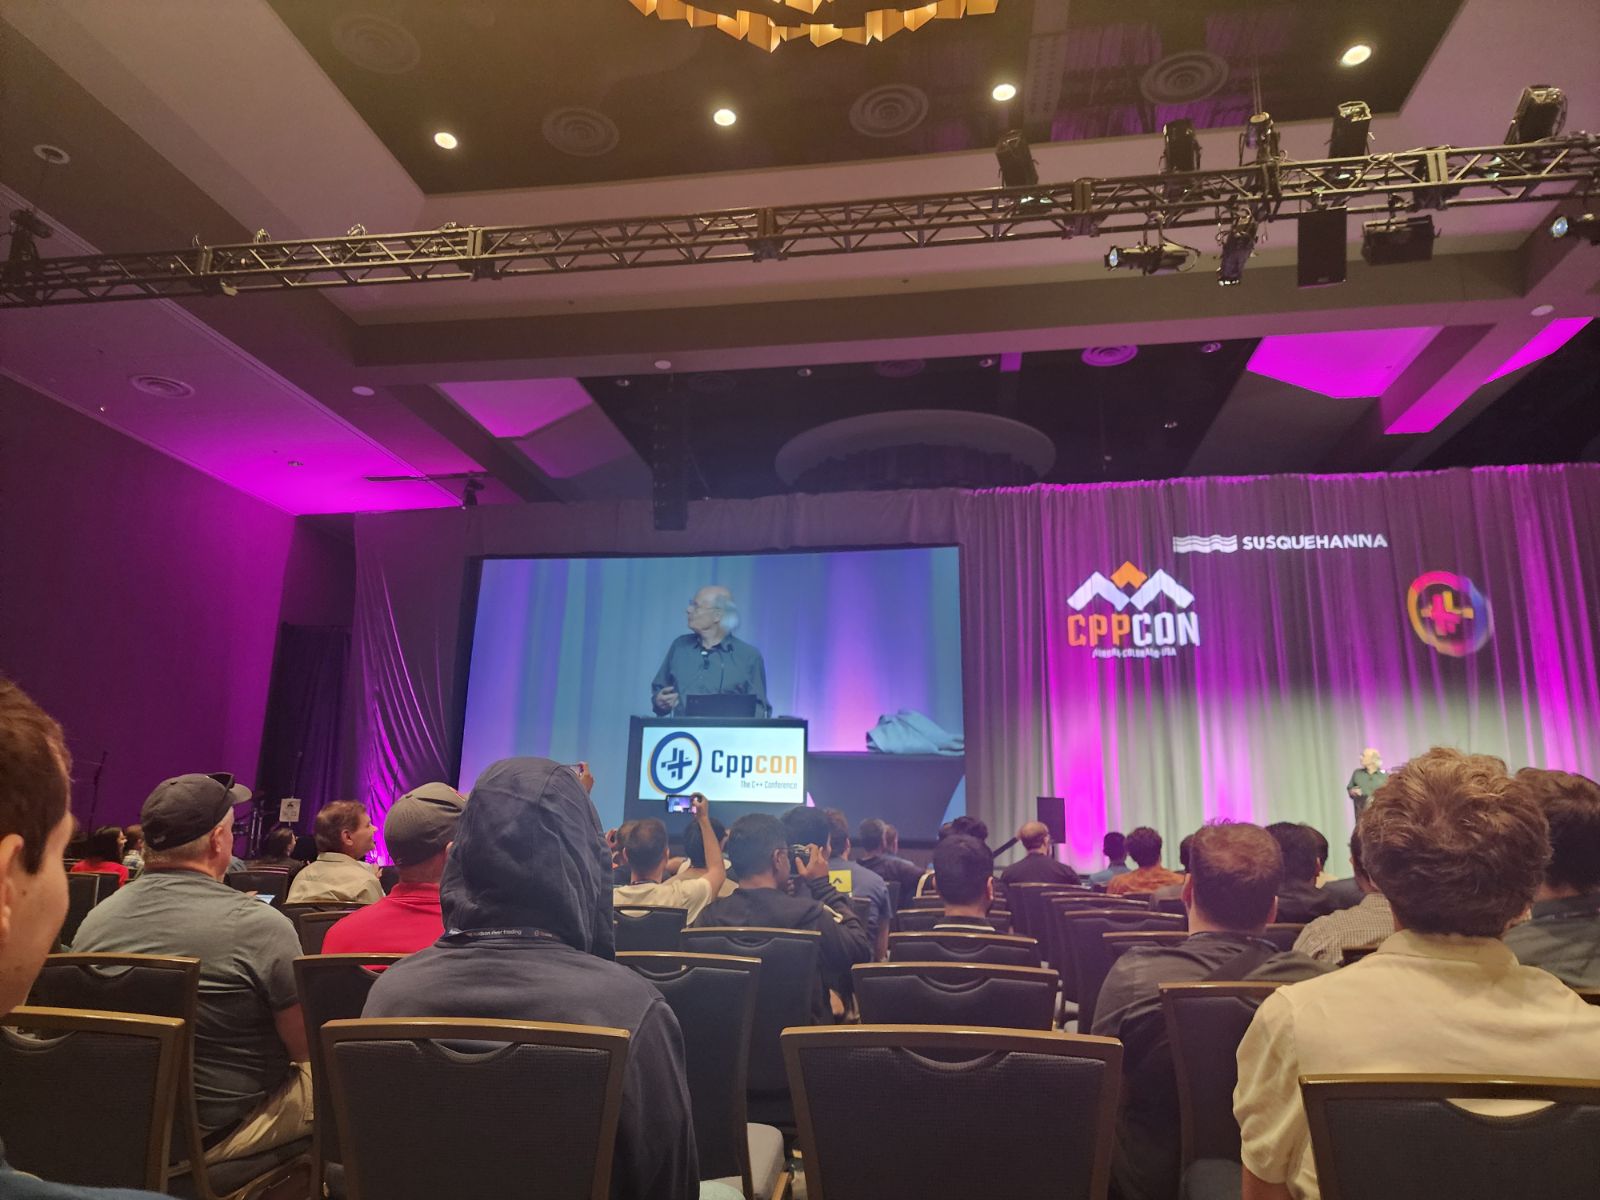
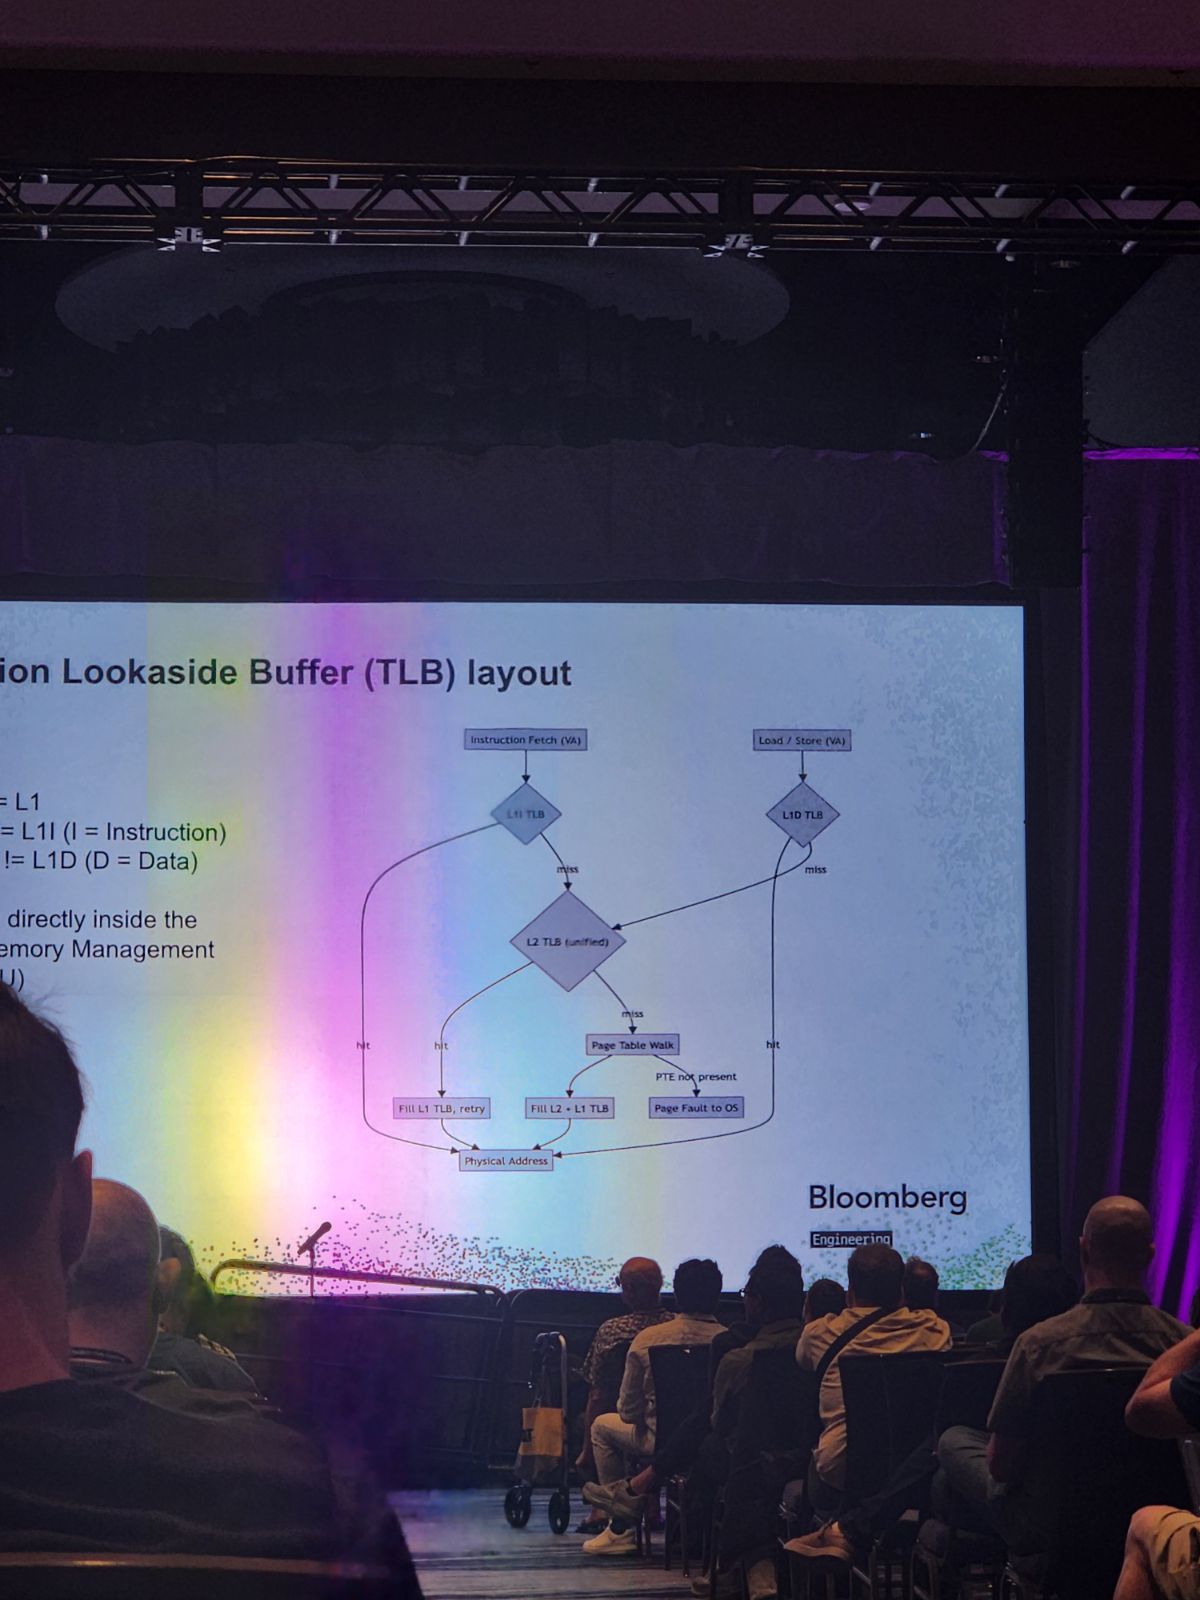
W aplikacjach C++ o bardzo niskiej latencji zrozumienie prostych abstrakcji językowych już nie wystarcza. W istocie pojęcie realiów leżącego u podstaw sprzętu (hardware) staje się niezbędne. Podczas swojej sesji Ofek Shilon omówił szczegółowo mechanizmy sprzętowe wykonywane podczas dostępu do pamięci. Wykazał również ich bezpośredni wpływ na ogólną wydajność oraz poprawność kodu.
Główny wniosek: Dostęp do pamięci w C++ nigdy nie odbywa się bezpośrednio w pamięci RAM. W rzeczywistości przechodzi przez kilka poziomów pamięci cache (L1/L2/L3).
- Pamięci cache & cache lines: pamięci cache operują na blokach o stałym rozmiarze, zazwyczaj 64 bajtów. Dostęp przekraczający granicę linii cache może wymagać operacji na dwóch różnych liniach i powodować dodatkowy narzut.
- Wyrównanie pamięci (memory alignment): dereferencja wskaźnika niespełniającego wymogów wyrównania może wywołać niezdefiniowane zachowanie (undefined behavior) w C++. Niczym nieodbiegające, strategiczne użycie
memcpypozwala na bezpieczne operowanie na niewyrównanych danych. - Model pamięci & współbieżność (concurrency):
std::atomicorazstd::memory_orderopierają się na mechanizmach sprzętowych, takich jak protokoły spójności cache (cache coherence), store buffers, kolejniki unieważnień (invalidation queues) oraz, w zależności od operacji, bariery pamięci (memory barriers).
Mechanizmy te są szczególnie istotne w systemach finansów rynkowych poddanych silnym rygorom latencji. W istocie lepsze zrozumienie hierarchii pamięci pozwala projektować struktury dostosowane do pamięci cache. Skutecznie zmniejsza to liczbę cache-misses w aplikacjach low latency. Jednakże każda optymalizacja niskiego poziomu musi zostać zweryfikowana za pomocą precyzyjnych pomiarów, aby uniknąć wprowadzania przedwczesnej złożoności.
2. Are You Smarter Than a Branch Predictor?
Michelle D’Souza — Podsumowanie techniczne
Zarządzanie odgałęzieniami warunkowymi (if, switch) jest obiektem wielu mitów w C++. Michelle D’Souza zdementowała powszechne przekonania, przedstawiając rzeczywiste działanie predyktorów odgałęzień (branch predictors) wbudowanych w nowoczesne procesory, takie jak predyktory TAGE czy Perceptron.
- Przewidywalność vs kod „Branchless”: błąd predykcji zmusza CPU do odrzucenia wykonywania spekulatywnego, powodując realny spadek wydajności. Jednakże systematyczne usuwanie gałęzi poprzez kod branchless (taki jak
conditional moves) nie zawsze jest szybsze i może wręcz dodawać niepotrzebne obliczenia. - Organizacja danych: w niektórych scenariuszach reorganizacja lub sortowanie danych może przekształcić trudne do przewidzenia odgałęzienia w bardziej regularne sekwencje, a tym samym łatwiejsze do przewidzenia przez procesor. Uzyskana korzyść musi być jednak zrównoważona z kosztem tej reorganizacji.
- PGO (Profile-Guided Optimization): kompilator wykorzystuje profile pochodzące z reprezentatywnych wykonań, aby lepiej zoptymalizować rzeczywiście pokonywane ścieżki: organizację kodu, decyzje dotyczące inliningu, gałęzie oraz inne transformacje.
3. When Zero-Cost Abstractions Aren’t Zero-Cost
Steve Sorkin — Podsumowanie techniczne
Nowoczesny C++ kładzie nacisk na zasadę zero-cost abstractions. Ideą jest używanie konstrukcji wysokiego poziomu, takich jak szablony (templates) czy ranges, bez ponoszenia narzutu w porównaniu z kodem niskiego poziomu pisanym ręcznie. Jednakże Steve Sorkin przypomniał o niuansach kryjących się za tą koncepcją.
Główny wniosek: Zero-cost abstraction to warunkowa umowa z optymalizatorem. Może nie generować dodatkowych kosztów, gdy kompilator dysponuje wystarczającymi informacjami o typach i przepływie sterowania (control flow), aby wyeliminować warstwę abstrakcji.
- Dynamic dispatch & Type Erasure:
std::functionmoże ukryć przed kompilatorem konkretny typ obiektu wywoływalnego (callable). W ścieżkach krytycznych ta utrata informacji może uniemożliwić inlining i pozostawić dispatch w czasie wykonywania (runtime dispatch). - Ranges, Views & kontenery pośrednie: choć
std::rangespozwala wyrazić przetwarzanie w sposób deklaratywny, ekspresyjny i elastyczny w komponowaniu, zachowując przy tym możliwość ewaluacji leniwej (lazy evaluation), wewnętrzna logika iteratorów może pozostać w wygenerowanym asemblerze. Co więcej, dzielenie przetwarzania poprzez tworzenie kontenerów pośrednich wywołuje prawdziwe i bardzo kosztowne alokacje dynamiczne. - Ograniczenia poziomu optymalizacji
-O3: wysoki poziom optymalizacji nie potrafi odtworzyć utraconej informacji o typie. Ponadto może zwiększyć rozmiar wygenerowanego asemblera i zwiększyć presję na instruction cache.
4. From Profiling to Automatic Benchmarking
Kris Jusiak — Podsumowanie techniczne
Optymalizacja złożonego kodu okazuje się trudna ze względu na obciążenia wynikające ze stanu pamięci cache, rozmieszczenia instrukcji czy zachowania branch predictora. Dlatego Kris Jusiak zaproponował zautomatyzowaną metodologię, pozwalającą przekroczyć ograniczenia tradycyjnych benchmarków.
- Pomiary mikroarchitektoniczne: wykorzystanie hardware performance counters oraz metody TMA (Top-Down Microarchitecture Analysis) pozwala precyzyjnie zrozumieć, dlaczego CPU przestaje działać optymalnie (stagne).
- Narzędzia badawcze: metodologia opiera się na łącznym wykorzystaniu
perf,bpftrace,LLVM XRay,Intel PToraz analizatorów asemblera, takich jakllvm-mca. - Automatic / Symbolic Benchmarking: podejście polega na automatycznym zmienianiu różnych warunków mikroarchitektonicznych podczas testów, aby zredukować niektóre błędy pomiarowe i uzyskać statystycznie bardziej stabilne wyniki.
Lightning Talk CppCon 2026: ekspertyza C++ w MARGO z Louise Kraffe
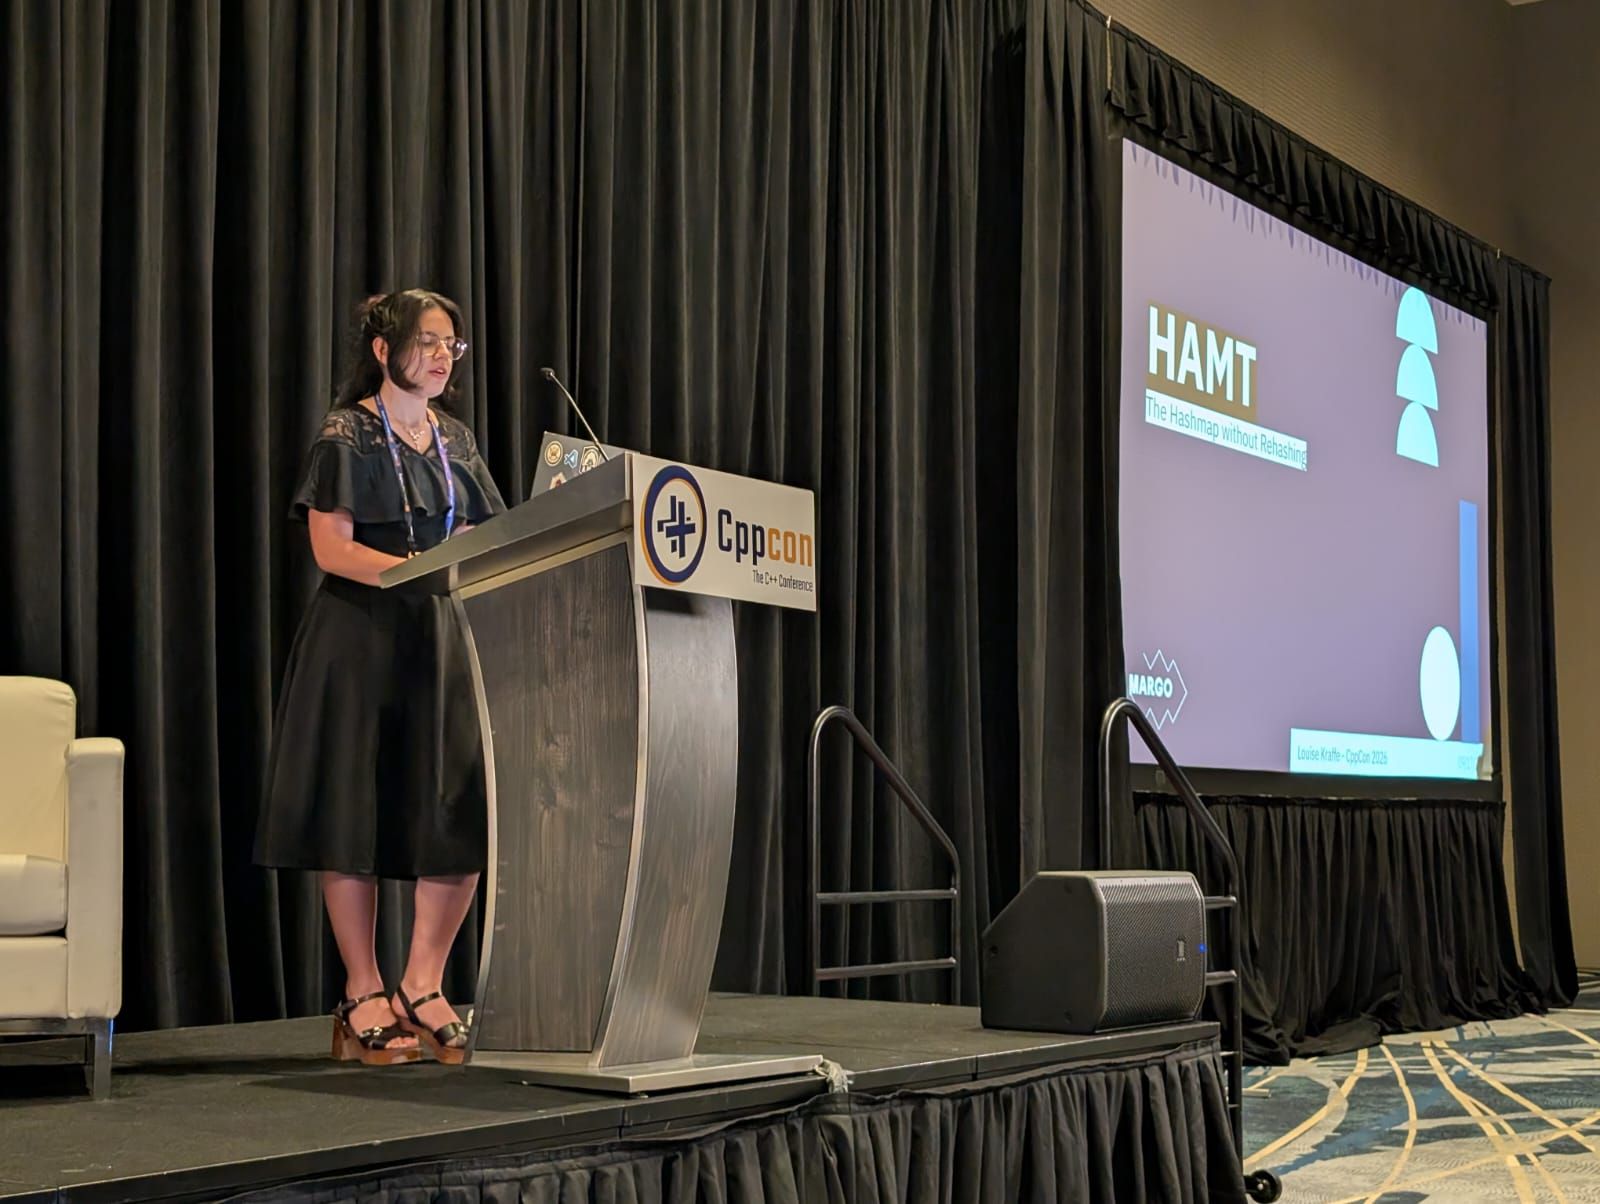
Poza samym śledzeniem trendów technologicznych MARGO aktywnie zachęca swoich konsultantów do wystąpień na międzynarodowych zgromadzeniach. W ten sposób Louise Kraffe wystąpiła na scenie, prezentując Lightning Talk skupiony na zaawansowanych strukturach danych.
HAMT: The Hashmap without Rehashing
W C++ standardowa struktura std::unordered_map opiera się na globalnej tablicy haszującej (hash table). Gdy wymagany jest rehash, tablica odbudowuje swoją strukturę kubełków (buckets) i redystrybuuje elementy zgodnie z nową pojemnością. Operacja ta może wprowadzać znaczący jednorazowy koszt.
Aby złagodzić to ograniczenie w systemach real-time oraz low latency, Louise zaprezentowała HAMT (Hash Array Mapped Trie). Jest to struktura drzewiasta, w której hash klucza jest dzielony na sekcje bitowe. Podejście to pozwala na stopniową nawigację po kompaktowych węzłach wykorzystujących maski bitowe (bitmaps).
- Brak globalnego rehashu: struktura ewoluuje lokalnie podczas wstawiania (insertions), eliminując źródło skoków latencji związanych z pełnym rehashem tablicy haszującej.
- Kompaktowe zarządzanie pamięcią: wykorzystanie bitmaps pozwala na przechowywanie wyłącznie rzeczywiście zajętych miejsc w drzewie.
- Kompromis wydajnościowy: w zaprezentowanych benchmarkach
std::unordered_mapuzyskuje lepsze średnie czasy wstawiania, podczas gdy HAMT wykazuje znacznie niższą latencję maksymalną wraz ze wzrostem wolumenu.
Temat ten bezpośrednio ilustruje niektóre wyzwania napotykane w systemach finansów rynkowych, gdzie stabilność latencji może być równie ważna jak średnia wydajność.
MARGO x CPPCon
Wymóg wysokiej złożoności w służbie naszych projektów
To zanurzenie w samym sercu CppCon 2026 potwierdza niepodważalną rzeczywistość nowoczesnej inżynierii oprogramowania: surowa wydajność i niezawodność nie powstają przez przypadek ani dzięki zwykłym intuicjom. Niezależnie od tego, czy chodzi o opanowanie architektury pamięci procesora, przewidywanie mechaniki predyktorów odgałęzień, odkrywanie rzeczywistego kosztu abstrakcji, czy projektowanie struktur danych zapobiegających skokom latencji, takich jak HAMT, zysk każdego cyklu wymaga głębokiego zrozumienia sprzętu (hardware).
W MARGO udział w tych wielkich międzynarodowych wydarzeniach nie stanowi zwykłego śledzenia trendów. Wciela w życie samą esencję naszego EXCELLENCE Hub: konfrontację z najbardziej rygorystycznymi światowymi standardami, aby natychmiast wnosić ten poziom wymagań do najważniejszych systemów informatycznych naszych klientów z obszarów bankowości inwestycyjnej, finansów rynkowych i DeepTech.
Co ta ekspertyza wnosi konkretnie do naszych projektów:
- Chirurgiczna jakość kodu: eliminacja złożonych wąskich gardeł (cache-misses, zbędnych alokacji dynamicznych, indyrekcji dynamicznej) już na etapie projektowania.
- Bezwzględna przewidywalność systemów: opanowanie latencji maksymalnej (tail latency) niezbędnej w środowiskach czasów rzeczywistych i dostępu do rynku.
- Metodologia oparta na dowodach: zastąpienie spekulacji dotyczących optymalizacji systematycznymi pomiarami, profilowaniem mikroarchitektonicznym i analizą kodu asemblera.
Chcesz porozmawiać o naszych doświadczeniach lub odkryć nasze możliwości w zakresie inżynierii C++?
Czym jest CppCon i jaka jest jego rola w ekosystemie C++?
CppCon to największa coroczna międzynarodowa konferencja poświęcona językowi C++. Organizowana w Stanach Zjednoczonych gromadzi ponad tysiąc ekspertów, twórców kompilatorów i deweloperów, aby dyskutować o ewolucji standardu (C++20, C++23, C++26) oraz najlepszych praktykach w zakresie wydajności oprogramowania.
Dlaczego zarządzanie modelem pamięci C++ jest krytyczne dla systemów low latency?
W aplikacjach o bardzo niskiej latencji, takich jak trading wysokich częstotliwości (high-frequency trading), RAM jest zbyt wolna. Zrozumienie modelu pamięci C++ pozwala na wyrównanie danych do rozmiaru linii pamięci cache procesora (64 bajty), zmniejszając w ten sposób liczbę cache-misses i optymalizując wykorzystanie pamięci cache L1/L2/L3.
Czym jest zero-cost abstraction w C++ i jakie są jej ograniczenia?
Zero-cost abstraction to funkcja wysokiego poziomu (taka jak szablony czy lambdy), która nie generuje żadnego dodatkowego kosztu w czasie wykonywania w porównaniu z kodem niskiego poziomu pisanym ręcznie. Jej ograniczenie pojawia się, gdy kompilator traci widoczność konkretnego typu (np. przy std::function), narzucając dynamiczną indyrekcję niemożliwą do inliningu.
Dlaczego warto używać struktury HAMT zamiast klasycznej std::unordered_map?
Struktura std::unordered_map podlega operacjom globalnego rehashu podczas zmiany rozmiaru, generując nieprzewidywalne skoki latencji. HAMT (Hash Array Mapped Trie) ewoluuje lokalnie bez globalnego rehashu, gwarantując niezwykle stabilną latencję wstawiania, niezbędną dla systemów czasu rzeczywistego (real-time).
Na czym polega optymalizacja kierowana profilowaniem (PGO) w C++?
PGO (Profile-Guided Optimization) to technika, w której kompilator wykorzystuje rzeczywiste dane z wykonania, aby zreorganizować kod asemblera. Pozwala to na zoptymalizowanie rozmieszczenia gałęzi warunkowych i inliningu funkcji na najczęściej wykonywanych ścieżkach kodu.
Jak EXCELLENCE Hub MARGO wspiera rozwój kompetencji w C++?
EXCELLENCE Hub MARGO organizuje Learning Expeditions na wydarzenia o zasięgu światowym, takie jak CppCon, finansuje co najmniej jedno szkolenie certyfikowane rocznie oraz prowadzi setki coachingów koleżeńskich (peer coaching). Pozwala to naszym inżynierom pozostawać w czołówce technologii krytycznych dla naszych klientów korporacyjnych (Grands Comptes / duże przedsiębiorstwa).