Wprowadzenie: dlaczego ta decyzja ma kluczowe znaczenie w 2026 roku
W 2026 roku integracja generatywnej AI z procesami firmy przestała być eksperymentem: to fundamentalna zmiana strategiczna. Liderzy technologii i danych stoją dziś przed kluczowym dylematem: fine-tuning dużych modeli językowych czy wdrożenie podejścia RAG (Retrieval-Augmented Generation). Ten wybór bezpośrednio decyduje o całkowitym koszcie posiadania (TCO), zwinności biznesowej, skalowalności i identyfikowalności danych.
Firmowe zbiory danych stale się zmieniają, wymogi regulacyjne się zaostrzają, a potrzeby biznesowe są coraz bardziej specyficzne. Jak wybrać właściwą drogę? Ten artykuł przedstawia kompleksową analizę porównawczą, wzbogaconą o doświadczenia z praktyki i konkretne rekomendacje, które pomogą CTO, CDO i interesariuszom biznesowym określić strategię AI.
Podstawy techniczne: RAG czy fine-tuning
Czym jest RAG?
RAG (Retrieval-Augmented Generation) łączy dwie kluczowe funkcje: inteligentne wyszukiwanie informacji w dokumentowej bazie wiedzy oraz generowanie tekstu na podstawie najtrafniejszych wyników.
W tym podejściu LLM pozostaje niezmieniony; jest za to dynamicznie wzbogacany aktualnymi danymi, filtrowanymi według konkretnego zapytania użytkownika.
Czym jest fine-tuning?
Fine-tuning polega na dostosowaniu wstępnie wytrenowanego modelu językowego (np. GPT lub Llama) do konkretnej dziedziny przez jego dalsze trenowanie na własnym zbiorze danych firmy.
Proces ten zmienia wewnętrzne parametry modelu, tak aby przyswoił on specyficzną terminologię, styl lub zachowania, których wymaga dana firma.
Jak RAG stał się standardem przemysłowym w 2026 roku
Od POC do produkcji: dojrzałość technologiczna i adopcja
W latach 2023–2024 RAG często nie wychodził poza etap POC (proof of concept). W 2026 roku stał się standardowym frameworkiem architektonicznym, w pełni zintegrowanym z pipeline’ami MLOps/LLMOps z solidnym monitoringiem, wersjonowaniem i kontrolą jakości.
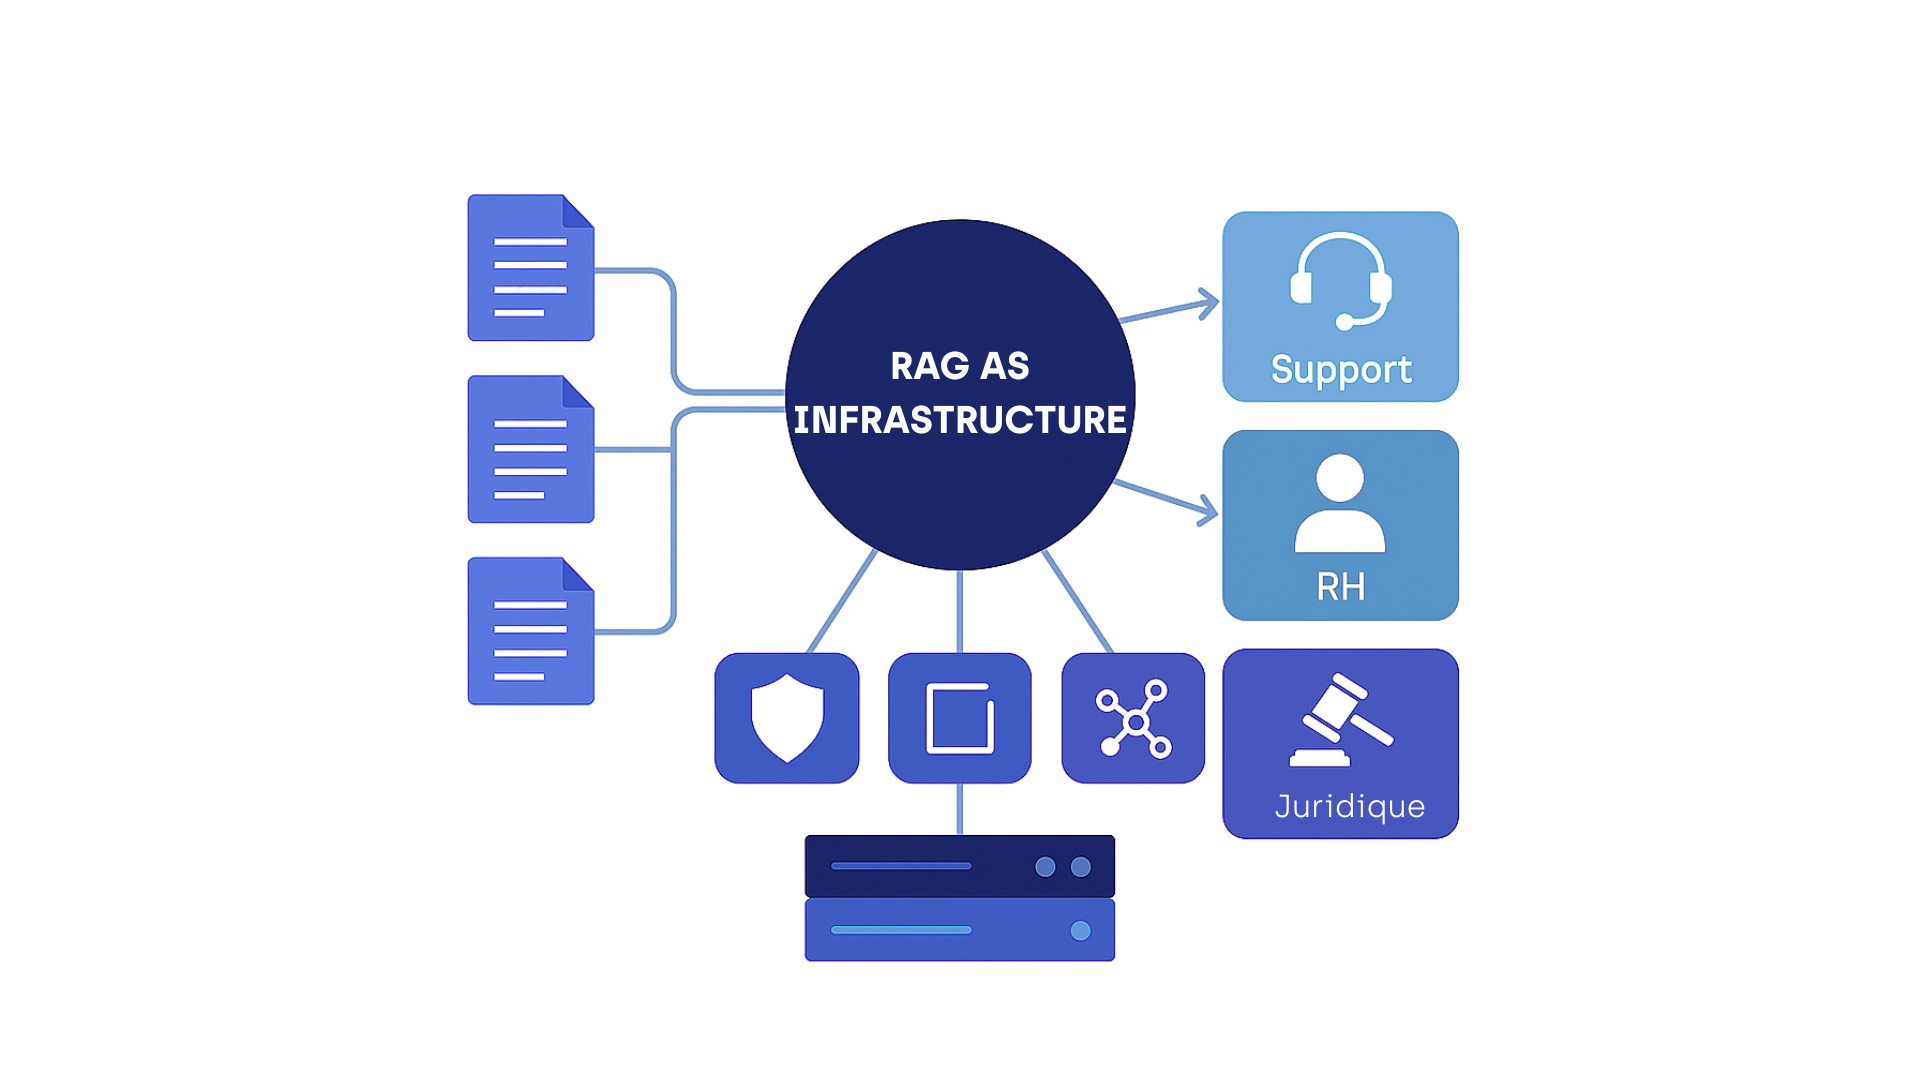
RAG jako infrastruktura: scentralizowana wiedza i zarządzanie dokumentacją
To podejście sprzyja scentralizowanemu zarządzaniu wiedzą i jednocześnie umożliwia ponowne wykorzystanie komponentów technicznych w różnych przypadkach użycia (od obsługi klienta i HR po dział prawny).
Znacząco skraca czas do uzyskania wartości, obniża koszty operacyjne i wzmacnia identyfikowalność danych.
Architektura RAG klasy „enterprise”: 5 niezbędnych komponentów
Solidny system RAG opiera się na modułowej architekturze dopasowanej do wymagań biznesowych. Oto pięć elementów niezbędnych w każdym poważnym wdrożeniu produkcyjnym.
Pozyskiwanie i wstępne przetwarzanie dokumentów
Jakość systemu RAG zależy przede wszystkim od korpusu wejściowego. Wymaga to inteligentnego parsowania, wzbogacania semantycznego, standaryzacji formatów i rygorystycznego wersjonowania dokumentów.
Hybrydowe indeksowanie wektorowe i metadane
Zastosowanie podejścia hybrydowego (łączącego wyszukiwanie gęste i rzadkie) zwiększa trafność odpowiedzi. Dzięki inteligentnemu wykorzystaniu metadanych (np. data, autor, dział) uzyskujesz bardzo precyzyjne filtrowanie biznesowe.
Inteligentna orkiestracja wyszukiwania
System wyszukiwania musi być adaptacyjny i korzystać z mechanizmów takich jak re-ranking, kontekstowy fallback oraz profilowanie użytkowników gwarantujących dostęp do najtrafniejszych danych.
Kontrolowane i kontekstowe generowanie
LLM musi trzymać się określonego tonu redakcyjnego, struktury odpowiedzi i reguł biznesowych. Wdrożenie ścisłego groundingu jest niezbędne, by zapobiegać halucynacjom i zapewnić zgodność generowanych odpowiedzi.
Obserwowalność i pętle informacji zwrotnej
Korporacyjna platforma RAG musi obejmować monitoring halucynacji, logowanie zapytań i narzędzia do zbierania opinii użytkowników wspierające ciągłe doskonalenie jakości odpowiedzi.
RAG czy fine-tuning: porównanie zalet i wad
Wybór między RAG a fine-tuningiem zależy od kryteriów operacyjnych, technicznych i ekonomicznych. Oto główne różnice, które musisz wziąć pod uwagę:
| Kryterium | Fine-tuning | RAG |
|---|---|---|
| Koszt | Wysoki (trenowanie, infrastruktura GPU) | Umiarkowany (bez ponownego trenowania) |
| Elastyczność | Niska (aktualizacja wymaga ponownego trenowania) | Wysoka (korpus można zaktualizować natychmiast) |
| Utrzymanie | Złożone (wymaga specjalistów AI) | Uproszczone (zarządzane przez pipeline danych) |
| Identyfikowalność | Niska (model jako „czarna skrzynka”) | Wysoka (widoczne źródła) |
| Częstotliwość aktualizacji | Niska | Wysoka |
Macierz decyzji biznesowej 2025: 4 kluczowe kryteria
W 2025 roku wybór między fine-tuningiem a RAG nie powinien opierać się wyłącznie na kryteriach technicznych. Musi wynikać z analizy konkretnych potrzeb biznesowych, ograniczeń dokumentacyjnych i wymogów regulacyjnych. Oto 4 najważniejsze kryteria biznesowe, każde zilustrowane przykładem z praktyki:
Częstotliwość aktualizacji dokumentów
Pytanie, które warto zadać: Jak szybko zmieniają się moje treści biznesowe?
RAG jest zalecany, jeśli: Twoja dokumentacja stale się zmienia (np. polityki HR, procedury IT, karty produktów, wewnętrzne przewodniki).
- Każdą zmianę w dokumencie można uwzględnić bez ponownego trenowania modelu.
- Generowane odpowiedzi pozostają aktualne, dopóki aktualizowany jest korpus.
Fine-tuning nie jest zalecany, jeśli: Treści często się zmieniają, bo każda aktualizacja wymaga kosztownego ponownego trenowania modelu.
Stabilność czy zmienność przypadków użycia
Pytanie, które warto zadać: Czy moje przypadki użycia są dobrze zdefiniowane i długoterminowe, czy stale się zmieniają?
Fine-tuning jest zalecany, jeśli: Przypadek użycia jest dobrze zdefiniowany, stabilny i powtarzalny, na przykład:
- Automatyczna klasyfikacja dokumentów.
- Standardowe odpowiedzi na ogromną liczbę zapytań.
- Generowanie treści ściśle sformatowanych lub regulowanych.
RAG jest zalecany, jeśli: Potrzeba jest zmienna lub eksploracyjna, na przykład:
- Kontekstowe wyszukiwanie w raportach.
- Wsparcie diagnostyki biznesowej.
- Dostęp do rozproszonych lub branżowych baz wiedzy.
Wymagany poziom kontroli nad odpowiedziami
Pytanie, które warto zadać: Czy muszę umieć uzasadnić lub udowodnić każdą wygenerowaną odpowiedź?
RAG jest zalecany, jeśli:
- Potrzebujesz wysokiego poziomu identyfikowalności.
- Musisz wskazać dokładne źródło, na podstawie którego wygenerowano odpowiedź.
- Twoi użytkownicy wymagają weryfikowalności na poziomie biznesowym (np. compliance, podatki).
Fine-tuning nie jest zalecany, jeśli: Trudno zweryfikować uzasadnienia modelu (odpowiedzi są wyuczone, ale nie mają wskazanych źródeł).
Ograniczenia regulacyjne i bezpieczeństwo
Pytanie, które warto zadać: Gdzie muszą być przechowywane moje dane? Jaki poziom poufności jest wymagany?
RAG jest zalecany, jeśli:
- Masz ograniczenia związane z suwerennością danych.
- Chcesz kontrolować środowisko hostingu (chmura prywatna lub on-premise).
- Korzystasz z modeli open source, takich jak Mistral czy Llama 3, by zachować pełną kontrolę.
Fine-tuning sprawdzi się gorzej, jeśli:
- Korzystasz z zamkniętego modelu hostowanego zewnętrznie (np. GPT-4 w Azure/OpenAI).
- Przetwarzasz dane wrażliwe, których nie można eksportować.
Typowe przypadki użycia dla każdego podejścia
Przypadki użycia odpowiednie dla fine-tuningu
Fine-tuning sprawdza się szczególnie w następujących kontekstach:
- Wyspecjalizowane chatboty w zamkniętych środowiskach, np. asystenci medyczni lub prawni, którzy wymagają bardzo specyficznej terminologii.
- Generowanie treści normatywnych, np. formalnych odpowiedzi na przetargi lub podsumowań regulacyjnych.
- Systemy wbudowane, w których połączenie z zewnętrzną bazą danych jest niemożliwe lub bardzo ryzykowne.
- Aplikacje B2C na dużą skalę, w których kluczowa jest optymalizacja wydajności przy niskich kosztach.
Idealne przypadki użycia dla RAG
RAG sprawdza się wszędzie tam, gdzie trzeba zindustrializować dostęp do zmieniającej się wiedzy biznesowej, zwłaszcza w obszarach takich jak:
- Wsparcie wewnętrzne (HR, IT, dział prawny).
- Biznesowe copiloty do zarządzania dokumentacją.
- Monitoring regulacyjny lub konkurencyjny.
- Onboarding nowych pracowników za pomocą dynamicznych FAQ.
Wskazanie właściwego przypadku użycia we właściwym momencie to zadanie strategiczne. Konsultanci AI MARGO pomogą Ci zmapować przypadki użycia i wyznaczyć pragmatyczną mapę drogową.
Studium przypadku: MargoZilla, wewnętrzny asystent RAG
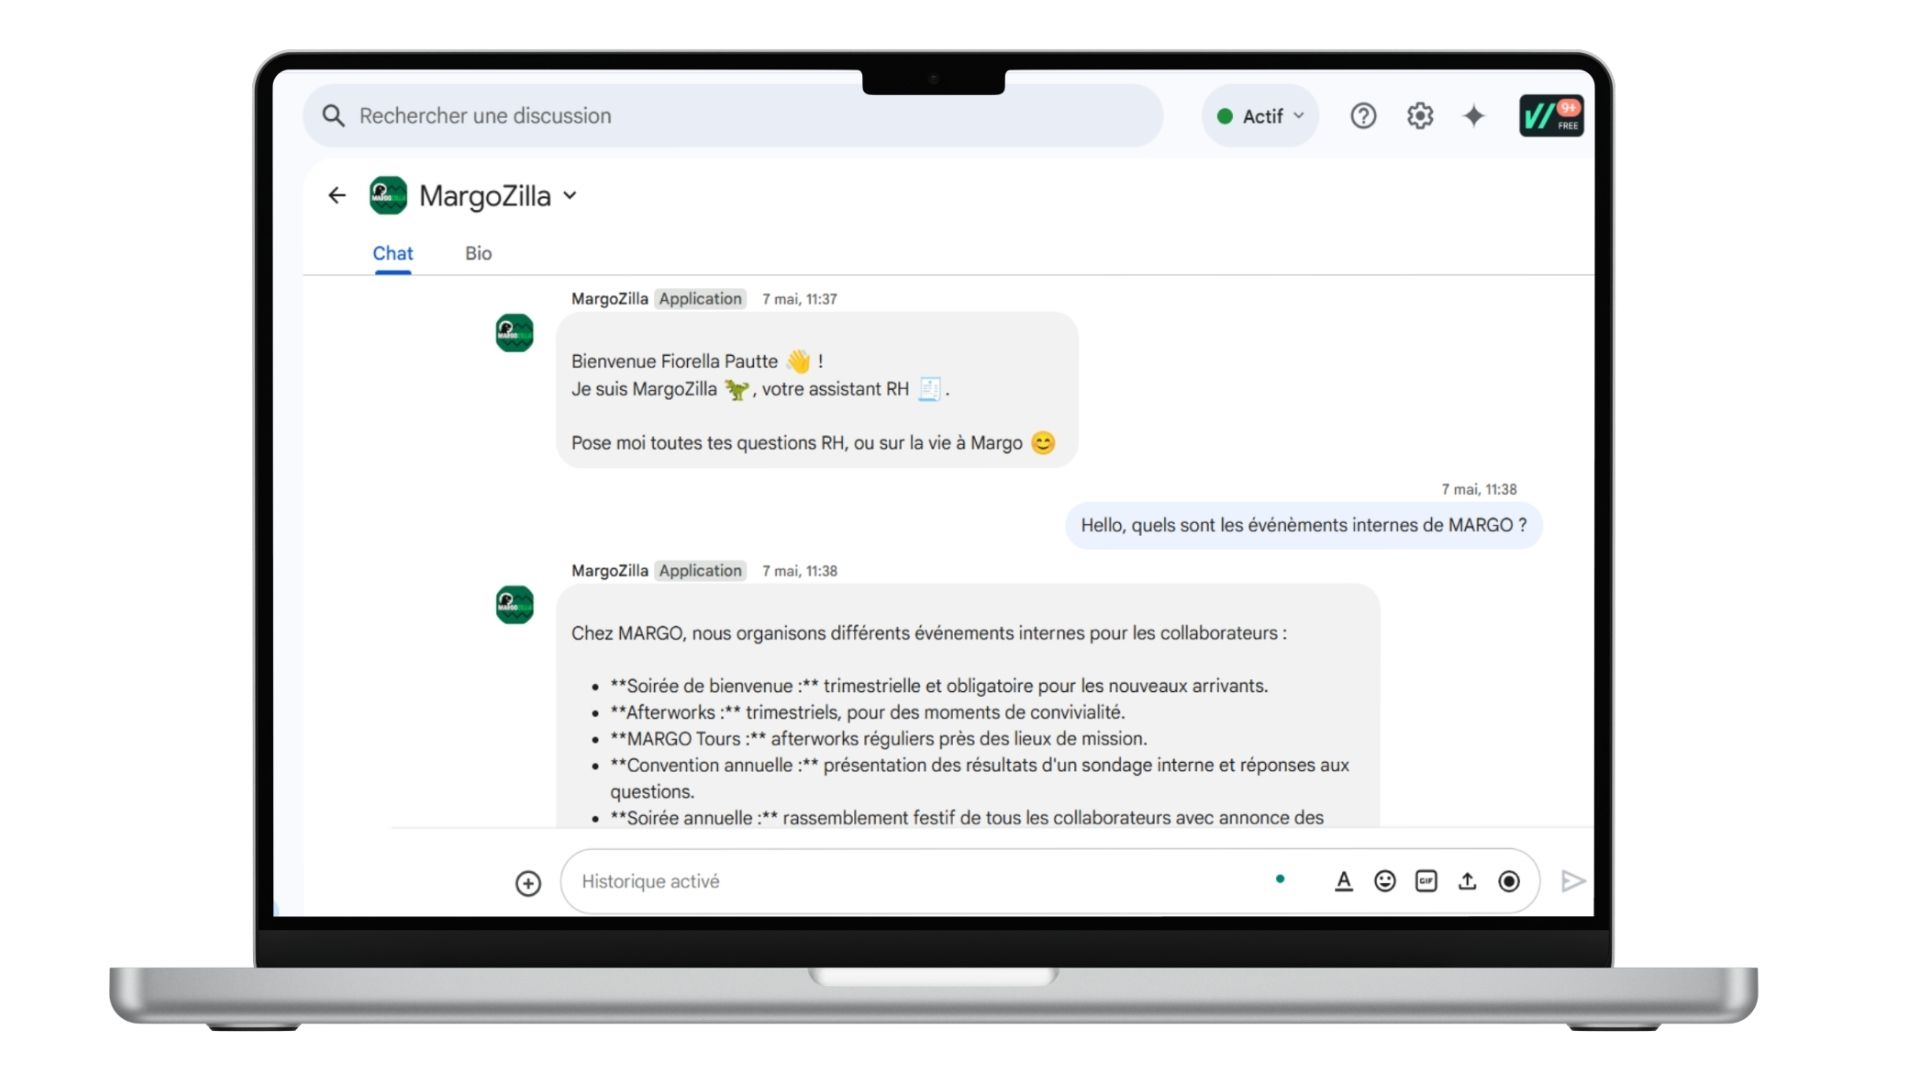
W MARGO asystent AI MargoZilla powstał, by wspierać nasze zespoły wewnętrzne. Automatycznie odpowiada na pytania pracowników dotyczące HR, IT, szkoleń i wydarzeń wewnętrznych. Zintegrowany z Google Drive, dostarcza odpowiedzi ze źródłami i kontekstem bezpośrednio w Google Chat.
Główne ograniczenia:
- Niejednorodny korpus dokumentów.
- Potrzeba rygorystycznego filtrowania, by zapobiegać halucynacjom i wyciekom informacji wrażliwych.
- Płynna integracja z Google Workspace.
Wyniki:
- Mniej zapytań do HR i IT.
- Szybka adopcja dzięki prostemu UX.
- Znaczna oszczędność czasu zespołów operacyjnych.
Wnioski z praktyki:
- Struktura korpusu = czynnik jakości nr 1.
- Metadane = precyzyjne filtrowanie i trafne odpowiedzi.
- Zautomatyzowany pipeline = zawsze aktualne dane.
- Integracja z procesami biznesowymi = łatwiejsza adopcja.
Ekosystem technologiczny RAG w 2025 roku
W 2025 roku industrializacja projektów RAG opiera się na solidnym, modułowym i interoperacyjnym łańcuchu technologicznym. Kilka narzędzi i frameworków stało się standardami de facto, a każde z nich obsługuje kluczowe ogniwo architektury.
LangChain: inteligentna orkiestracja przepływów pracy LLM
LangChain stał się podstawowym frameworkiem do budowania łańcuchów wywołań między LLM, wyszukiwarką, bazą danych lub API.
LangServe / LangSmith: zintegrowane narzędzia do udostępniania endpointów API i monitorowania łańcuchów na produkcji.
- Wyjątkowa modułowość (agenci, narzędzia, pamięć itd.)
- Połączenie ze wszystkimi głównymi modelami (OpenAI, Anthropic, Hugging Face itd.)
- Zaawansowana orkiestracja zadań sekwencyjnych lub równoległych
LlamaIndex: zaawansowane i dynamiczne zarządzanie korpusem
Dawniej GPT Index, LlamaIndex to wyspecjalizowane narzędzie do łączenia korpusu dokumentów z LLM. Doskonale radzi sobie z budową wydajnych, aktualnych indeksów.
- Inteligentne pozyskiwanie danych nieustrukturyzowanych
- Niestandardowy i kontekstowy chunking
- Połączone grafy dokumentów
Haystack: solidny pipeline NLP z natywną identyfikowalnością
Rozwijany przez Deepset, Haystack to framework open source skoncentrowany na wyszukiwaniu semantycznym, generowaniu wspomaganym i identyfikowalności.
- Natywne wsparcie architektur RAG
- Monitoring wydajności i wyjaśnialność wyników
- Łatwa integracja z Elasticsearch, OpenSearch i Qdrant
Qdrant, Weaviate, FAISS: silniki wektorowe w sercu RAG
Te wektorowe bazy danych to „mózg” systemu RAG. Zamieniają dokumenty na wektory liczbowe i przy każdym zapytaniu wyszukują te najbardziej trafne.
- Qdrant: open source, zaawansowane filtrowanie, cloud-native – kontekstowe wsparcie biznesowe
- Weaviate: zintegrowane grafy, schema-first, API REST+GraphQL – wyszukiwanie relacyjne
- FAISS: bardzo wysoka wydajność, obsługa GPU, prostota – wydajne przypadki użycia on-premise
Kryteria wyboru z perspektywy biznesu:
- Opóźnienie: szybkość reakcji w interfejsach użytkownika.
- Filtrowanie: możliwość łączenia wektorów i metadanych.
- Koszty infrastruktury: zoptymalizowane rozwiązania hostingowe.
- Zgodność z RODO: suwerenna chmura czy chmura publiczna.
- Scenariusze on-premise: FAISS i Qdrant to doskonali kandydaci.
Konwergencja AI: w stronę autonomicznych asystentów kognitywnych
Przyszłość RAG wykracza poza kontekstowe generowanie tekstu. Obserwujemy jego łączenie z innymi nowymi podejściami AI, które zmienia RAG w prawdziwe inteligentne copiloty biznesowe.
Agenci LLM + RAG: automatyzacja złożonych przepływów pracy
Frameworki takie jak LangChain Agents, CrewAI i AutoGPT pozwalają modelom LLM stać się autonomicznymi agentami, które potrafią:
- Zaplanować sekwencję działań (wyszukiwanie + analiza + odpowiedź).
- Wywoływać zewnętrzne API, np. bazę danych CRM lub system ERP.
- Działać na podstawie wyników, np. przygotować raport, utworzyć zgłoszenie lub wygenerować rekomendację.
- Automatyczne przygotowanie spersonalizowanego planu szkoleń na podstawie rozmów z HR.
- Opracowanie raportu z działalności na podstawie logów biznesowych i e-maili.
Multimodalność: RAG poza tekstem
Funkcje multimodalne zmieniają RAG we wszechstronne i immersyjne narzędzie:
- Odczyt zeskanowanych plików PDF, planów i schematów.
- Przetwarzanie obrazów (np. ilustrowanych instrukcji przemysłowych).
- Generowanie wzbogaconych treści (wykresy, diagramy, interfejsy wizualne).
- Utrzymanie ruchu w przemyśle: rozpoznanie części na podstawie zdjęcia i wygenerowanie karty technicznej.
- Wsparcie techniczne: analiza wiadomości głosowej i odnalezienie właściwej dokumentacji.
Live RAG + grafy wiedzy
„Live RAG” łączy generowanie wspomagane ze źródłami danych w czasie rzeczywistym: bazami SQL, wewnętrznymi API, narzędziami BI itd.
Cel: Tworzenie hybrydowych odpowiedzi, które łączą:
- Podsumowania tekstowe.
- Dane lub wskaźniki na żywo.
Grafy wiedzy: Pozwalają uporządkować wiedzę (encje i relacje), dzięki czemu odpowiedzi są precyzyjniejsze i lepiej uzasadnione.
- Zarządzanie sprzedażą: podsumowanie klienta połączone z jego historią i bieżącymi KPI.
- Diagnostyka finansowa: zestawienie zasad rachunkowości z danymi finansowymi w czasie rzeczywistym.
Podsumowanie
RAG w 2025 roku to już nie tylko narzędzie dostępu do dokumentów, ale strategiczny fundament do budowy inteligentnych, niezawodnych, elastycznych i połączonych asystentów. Jest częścią dojrzałego ekosystemu technologicznego na styku NLP, inżynierii danych, autonomicznych agentów i grafów wiedzy.
Potrzebujesz copilota AI w swojej organizacji?
Chcesz zindustrializować POC lub zoptymalizować istniejący system RAG?
Zabezpieczamy realizację Twoich projektów AI, dopasowujemy technologię do Twoich wyzwań i przyspieszamy Twoją transformację danych.