Learning Expedition à la CppCon 2026 pour MARGO : de retour du plus grand rassemblement mondial C++ au Colorado, retrouvez notre décryptage des conférences majeures et le résumé de la Lightning Talk présentée par Louise Kraffe sur la scène internationale.
MARGO à CppCon 2026 : au cœur du plus grand rassemblement C++ mondial
Chaque année aux États-Unis, la CppCon s’impose comme la référence absolue des conférences consacrées au langage C++. Pendant une semaine complète, plus de mille développeurs, architectes logiciels et concepteurs d’outils se réunissent. En effet, cet événement majeur permet de façonner l’avenir du langage et d’échanger sur les architectures système soumises à de fortes contraintes de performance.
CppCon 2026 : l’excellence C++ en Learning Expedition
Systèmes embarqués, trading haute fréquence, robotique ou infrastructures IA : la CppCon couvre l’ensemble des domaines où la performance brute et la faible latence sont critiques.
experts & participants
sessions & ateliers
d’immersion technique
D’une part, maintenir un niveau d’excellence exige d’être présent là où le futur de la tech se décide. D’autre part, l’organisation de nos Learning Expeditions via notre Pôle EXCELLENCE répond à un objectif clair : confronter nos experts aux meilleurs spécialistes mondiaux. Par ailleurs, nous réinjectons directement cette valeur ajoutée au cœur des projets critiques de nos clients.
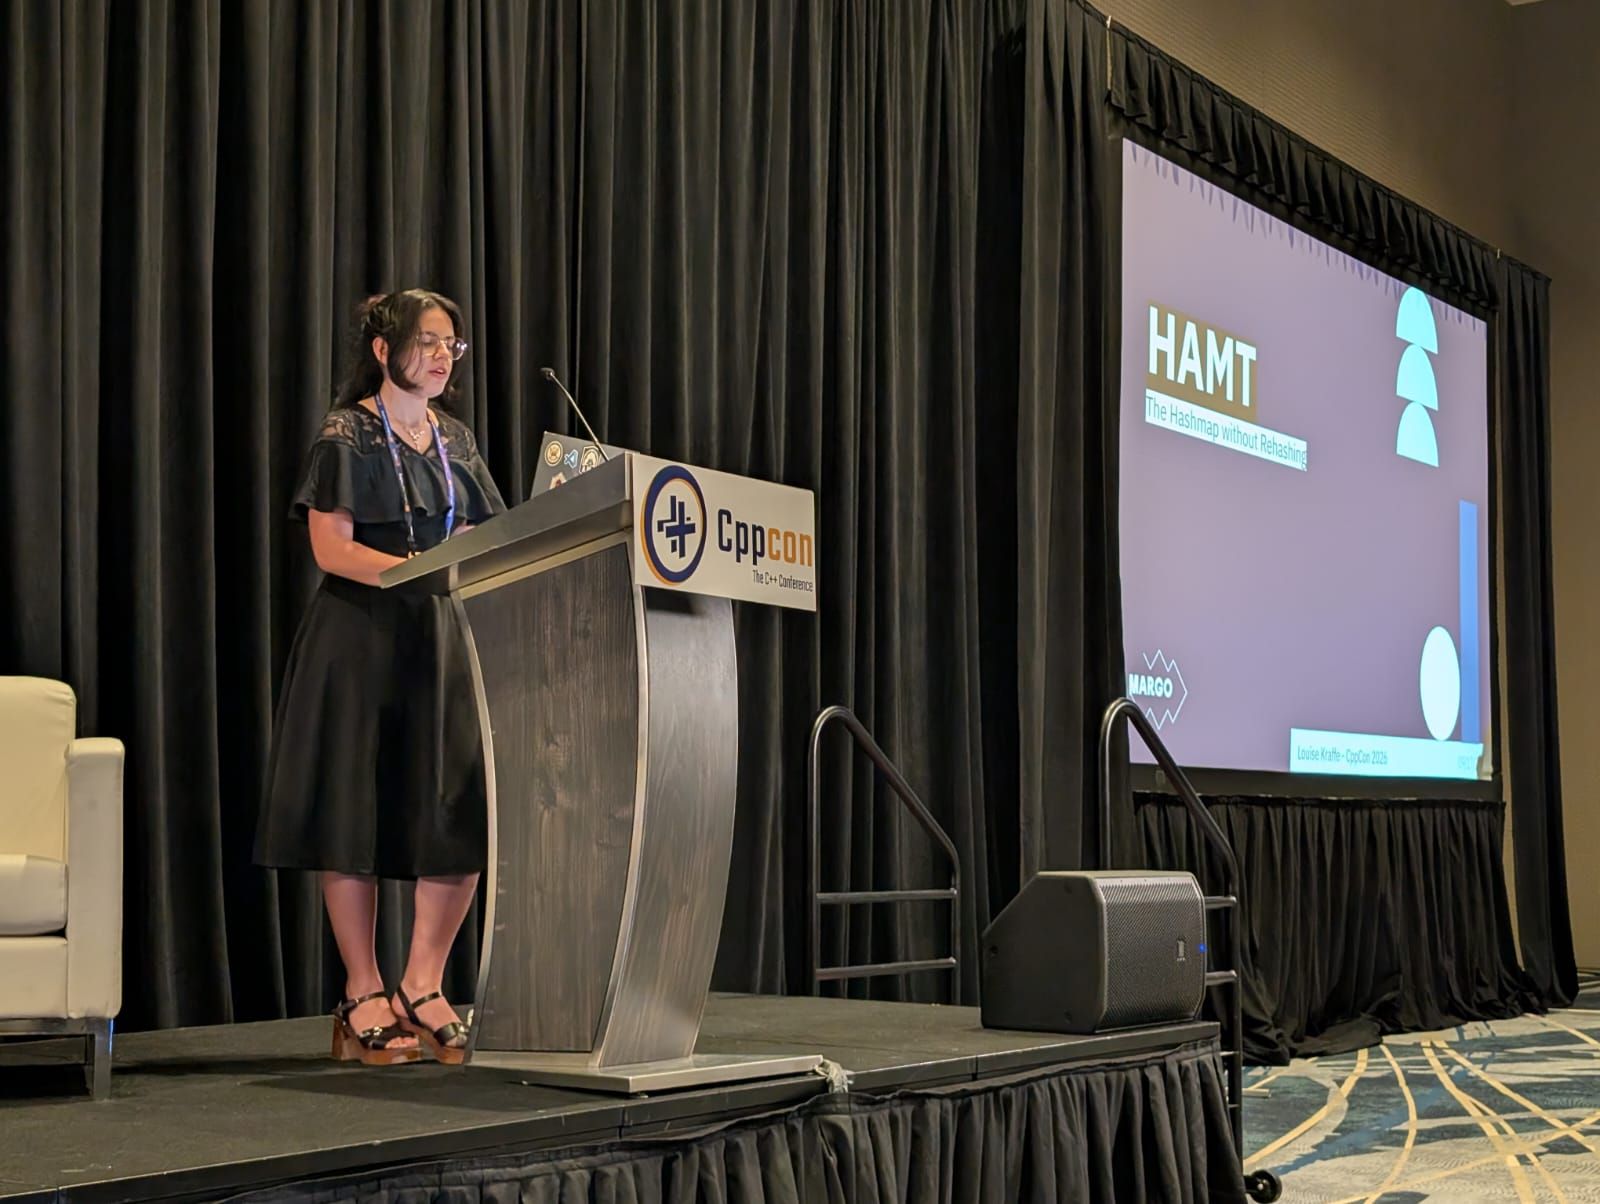
C’est précisément dans cette dynamique que Louise Kraffe a représenté nos équipes au Colorado. En plus de suivre les conférences, elle est montée sur scène lors d’une Lightning Talk. Son intervention était dédiée aux structures de données low latency avec la présentation de l’algorithme HAMT (Hash Array Mapped Trie).
CppCon 2026 : compte-rendu technique des conférences C++
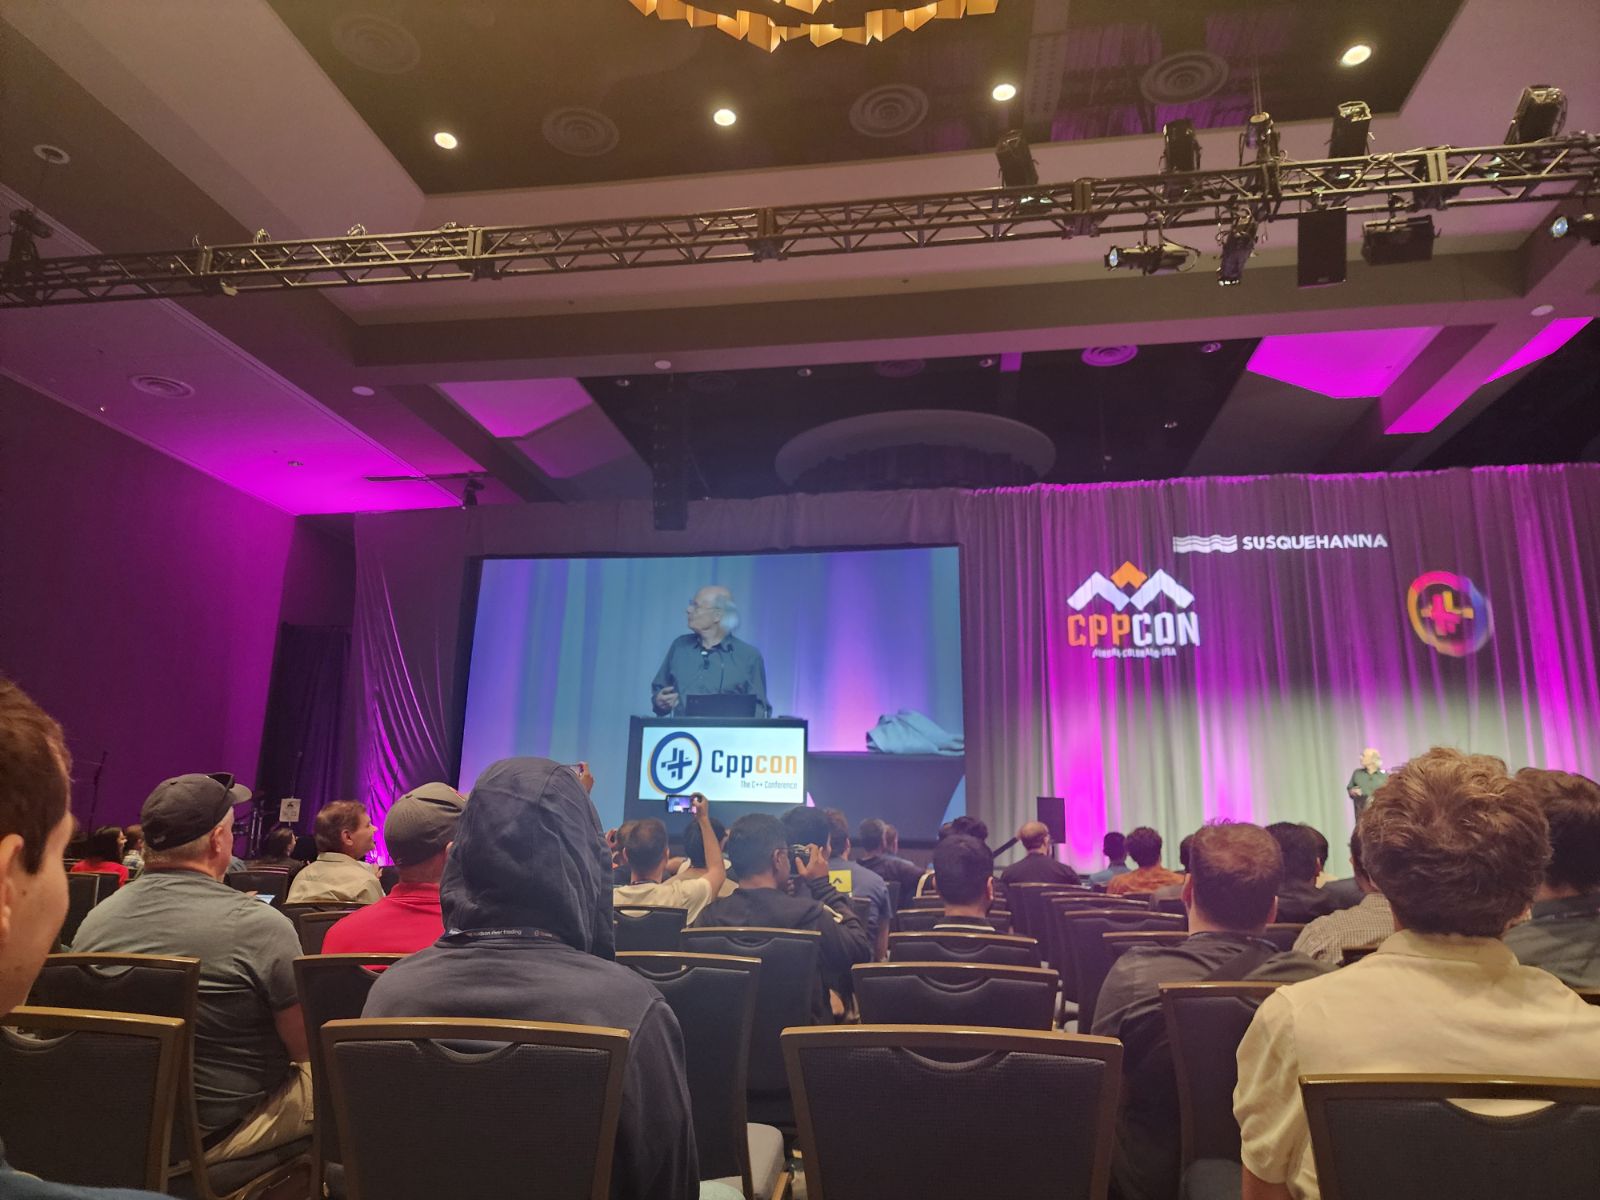
1. Processor Design and C++ Memory Models
Par Ofek Shilon — Synthèse technique
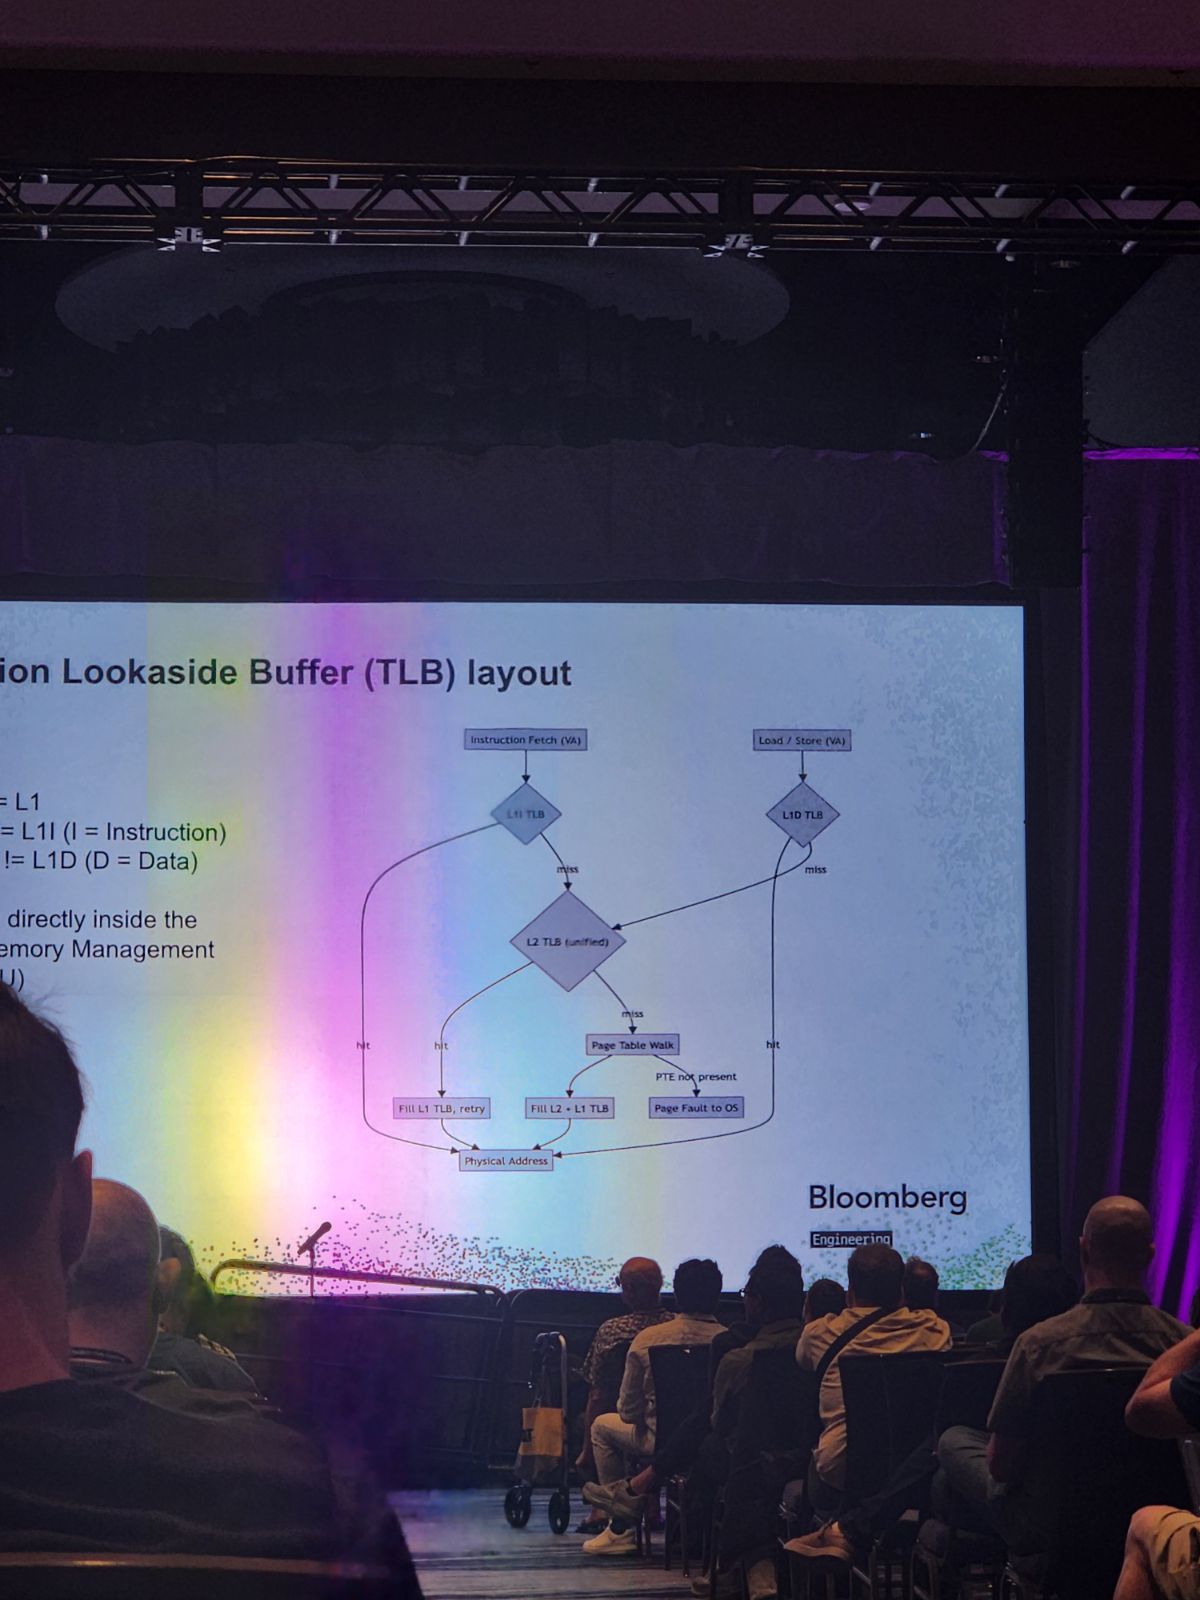
Dans les applications C++ à très faible latence, comprendre les simples abstractions du langage ne suffit plus. En effet, appréhender la réalité du matériel sous-jacent devient indispensable. Lors de sa session, Ofek Shilon a détaillé les mécanismes matériels exécutés lors des accès mémoire. Il a également démontré leur impact direct sur la performance globale et sur la justesse du code.
L’enseignement majeur : un accès mémoire en C++ ne s’effectue jamais directement en RAM. En réalité, il traverse plusieurs niveaux de caches (L1/L2/L3).
- Caches & cache lines : les caches manipulent des blocs de taille fixe, typiquement 64 octets. Un accès traversant une frontière de ligne de cache peut nécessiter la manipulation de deux lignes différentes et entraîner un surcoût.
- Alignement mémoire : déréférencer un pointeur ne respectant pas les contraintes d’alignement peut provoquer un comportement indéfini en C++. Néanmoins, l’usage stratégique de
memcpypermet de manipuler des données non alignées en toute sécurité. - Modèle mémoire & concurrence :
std::atomicetstd::memory_orderreposent sur des mécanismes matériels tels que les protocoles de cohérence de cache, les store buffers, les files d’invalidation et, selon les opérations, des barrières mémoire.
Ces mécanismes sont particulièrement pertinents dans les systèmes de finance de marché soumis à de fortes contraintes de latence. En effet, une meilleure compréhension de la hiérarchie mémoire permet de concevoir des structures adaptées aux caches. Cela réduit efficacement les cache-misses dans les applications low latency. Toutefois, toute optimisation bas niveau doit être validée par des mesures précises afin d’éviter d’ajouter de la complexité prématurée.
2. Are You Smarter Than a Branch Predictor?
Par Michelle D’Souza — Synthèse technique
La gestion des branchements conditionnels (if, switch) fait l’objet de nombreuses idées reçues en C++. Michelle D’Souza a donc démystifié le fonctionnement réel des prédicteurs de branchement intégrés aux processeurs modernes, comme les prédicteurs TAGE ou Perceptron.
- Prédictibilité vs Code « Branchless » : une erreur de prédiction force le CPU à purger son travail spéculatif, générant une réelle pénalité de performance. Pour autant, supprimer systématiquement les branches via du code branchless (comme les
conditional moves) n’est pas toujours plus rapide et peut même ajouter des calculs inutiles. - Organisation des données : dans certains scénarios, réorganiser ou trier les données peut transformer des branchements difficiles à prédire en séquences plus régulières et donc plus faciles à anticiper par le processeur. Le gain obtenu doit toutefois être mis en balance avec le coût de cette réorganisation.
- PGO (Profile-Guided Optimization) : le compilateur exploite des profils issus d’exécutions représentatives afin de mieux optimiser les chemins réellement empruntés : organisation du code, décisions d’inlining, branches et autres transformations.
3. When Zero-Cost Abstractions Aren’t Zero-Cost
Par Steve Sorkin — Synthèse technique
Le C++ moderne met en avant le principe des zero-cost abstractions. L’idée est d’utiliser des constructions haut niveau, telles que les templates ou les ranges, sans subir de pénalité par rapport à du code bas niveau. Cependant, Steve Sorkin a rappelé la réalité nuancée derrière ce concept.
L’enseignement majeur : une zero-cost abstraction est un contrat conditionnel avec l’optimiseur. Elle peut être sans surcoût lorsque le compilateur dispose de suffisamment d’informations sur les types et le flux de contrôle pour éliminer la couche d’abstraction.
- Dispatch dynamique & Type Erasure :
std::functionpeut masquer au compilateur le type concret du callable. Dans les chemins critiques, cette perte d’information peut empêcher l’inlining et laisser subsister un dispatch à l’exécution. - Ranges, Views & conteneurs intermédiaires : bien que
std::rangespermette d’exprimer un traitement de manière déclarative, expressive et composable, tout en pouvant conserver une évaluation lazy, la logique interne des itérateurs peut subsister dans l’assembleur généré. De surcroît, découper un traitement en matérialisant des conteneurs intermédiaires provoque de vraies allocations dynamiques très coûteuses. - Les limites du niveau d’optimisation
-O3: un niveau d’optimisation élevé ne peut pas reconstituer une information de type perdue. Par ailleurs, il peut accroître la taille de l’assembleur généré et augmenter la pression sur l’instruction cache.
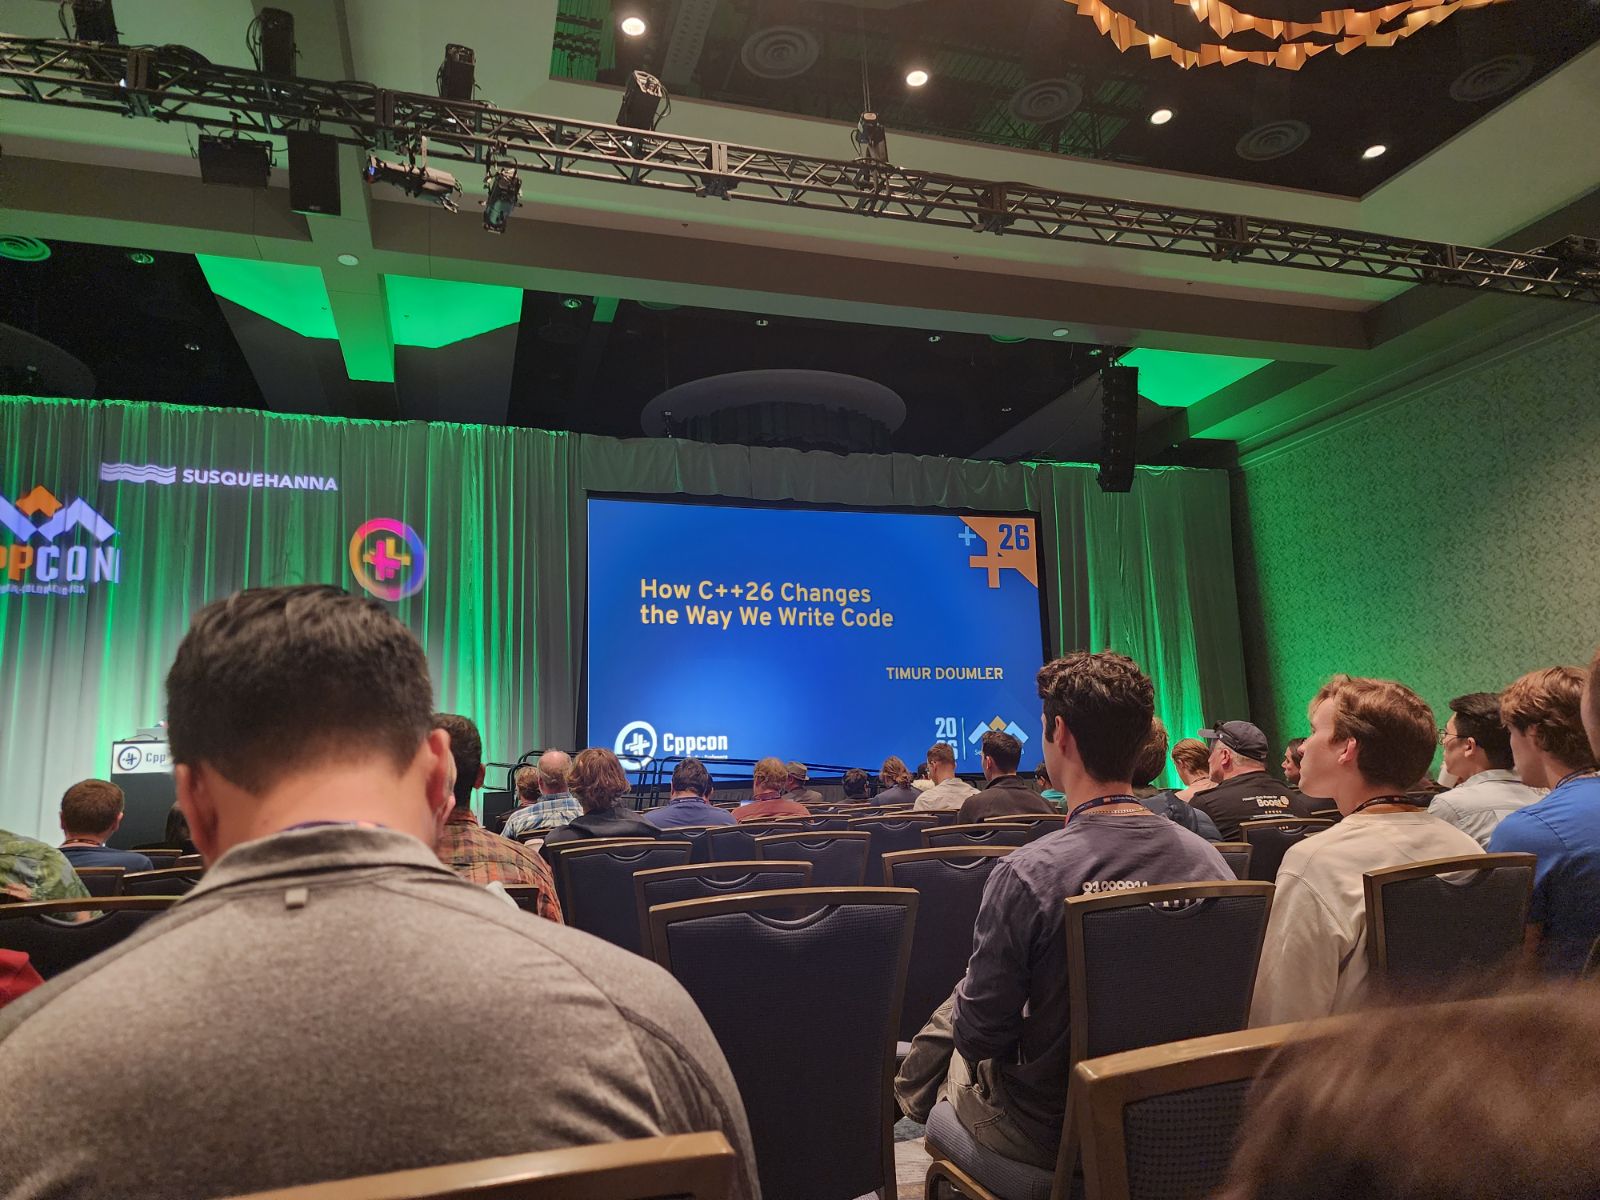
4. From Profiling to Automatic Benchmarking
Par Kris Jusiak — Synthèse technique
Optimiser un code complexe s’avère difficile en raison des biais induits par l’état du cache, la disposition des instructions ou le comportement du branch predictor. C’est pourquoi Kris Jusiak a proposé une méthodologie automatisée pour dépasser les limites des benchmarks traditionnels.
- Mesure microarchitecturale : l’exploitation des hardware performance counters et de la méthode TMA (Top-Down Microarchitecture Analysis) permet de comprendre précisément pourquoi un CPU stagne.
- Outillage d’investigation : la méthodologie s’appuie sur une utilisation combinée de
perf,bpftrace,LLVM XRay,Intel PTet d’analyseurs d’assembleur tels quellvm-mca. - Automatic / Symbolic Benchmarking : l’approche consiste à faire varier automatiquement différentes conditions microarchitecturales pendant les tests afin de réduire certains biais de mesure et d’obtenir des résultats statistiquement plus robustes.
Lightning Talk CppCon 2026 : l’expertise C++ de MARGO avec Louise Kraffe
Au-delà de la veille technologique, MARGO encourage activement ses consultants à prendre la parole lors des rassemblements internationaux. Ainsi, Louise Kraffe est montée sur scène pour présenter une Lightning Talk axée sur les structures de données avancées.
HAMT: The Hashmap without Rehashing
En C++, la structure standard std::unordered_map repose sur une table de hachage globale. Lorsqu’un rehash est nécessaire, la table reconstruit sa structure de buckets et redistribue les éléments selon la nouvelle capacité. Cette opération peut introduire un coût ponctuel important.
Pour pallier cette contrainte dans les systèmes real-time et low latency, Louise a présenté le HAMT (Hash Array Mapped Trie). Il s’agit d’une structure en arbre où le hash d’une clé est découpé en tranches de bits. Cette approche permet de naviguer progressivement à travers des nœuds compacts utilisant des masques de bits (bitmaps).
- Absence de rehash global : la structure évolue localement lors des insertions, supprimant la source de pics de latence associée au rehash complet d’une table de hashage.
- Gestion mémoire compacte : l’utilisation des bitmaps permet de ne stocker que les emplacements réellement occupés dans l’arbre.
- Compromis de performance : dans les benchmarks présentés,
std::unordered_mapobtient de meilleurs temps moyens d’insertion, tandis que le HAMT présente une latence maximale nettement inférieure lorsque le volume augmente.
Ce sujet illustre directement certains enjeux rencontrés dans les systèmes de finance de marché, où la stabilité de la latence peut être aussi importante que la performance moyenne.
MARGO x CPPCon
L’exigence de la haute complexité au service de nos projets
Cette immersion au cœur de la CppCon 2026 confirme une réalité incontournable de l’ingénierie logicielle moderne : la performance brute et la fiabilité ne s’obtiennent pas par hasard ou par de simples intuitions. Qu’il s’agisse de maîtriser l’architecture mémoire du processeur, d’anticiper la mécanique des prédicteurs de branchement, de lever le voile sur le coût réel des abstractions ou de concevoir des structures de données anti-pics de latence comme le HAMT, chaque gain de cycle exige une compréhension intime du matériel.
Chez MARGO, la participation à ces grands rendez-vous internationaux ne constitue pas un simple exercice de veille. Elle incarne l’essence même de notre Pôle EXCELLENCE : se confronter aux standards mondiaux les plus stricts pour réinjecter immédiatement ce niveau d’exigence au cœur des systèmes informatiques les plus critiques de nos clients en Banque d’investissement, Finance de marché et DeepTech.
Ce que cette expertise apporte concrètement à nos projets :
- Une qualité chirurgicale du code : élimination des goulots d’étranglement complexes (cache-misses, allocations dynamiques superflues, indirection dynamique) dès la phase de conception.
- Une prédictibilité absolue des systèmes : maîtrise de la latence maximale (tail latency) indispensable aux environnements temps réel et d’accès marché.
- Une méthodologie fondée sur la preuve : substitution des spéculations d’optimisation par la mesure systématique, le profilage microarchitectural et l’analyse du code assembleur.
Vous souhaitez échanger sur nos retours d’expérience ou découvrir nos opportunités en ingénierie C++ ?
Qu’est-ce que la CppCon et quel est son rôle dans l’écosystème C++ ?
La CppCon est la plus grande conférence internationale annuelle consacrée au langage C++. Organisée aux États-Unis, elle rassemble plus de mille experts, concepteurs de compilateurs et développeurs pour discuter des évolutions du standard (C++20, C++23, C++26) et des meilleures pratiques pour la performance logicielle.
Pourquoi la gestion du modèle mémoire C++ est-elle critique pour les systèmes low latency ?
Dans les applications à très faible latence, comme le trading haute fréquence, la RAM est trop lente. Comprendre le modèle mémoire C++ permet d’aligner les données sur la taille des lignes de cache du processeur (64 octets), réduisant ainsi les cache-misses et optimisant l’usage de la mémoire cache L1/L2/L3.
Qu’est-ce qu’une zero-cost abstraction en C++ et quelles sont ses limites ?
Une zero-cost abstraction est une fonctionnalité haut niveau (comme les templates ou les lambdas) qui ne génère aucun surcoût à l’exécution par rapport à du code bas niveau écrit à la main. Sa limite survient lorsque le compilateur perd la visibilité du type concret (ex: avec std::function), imposant alors une indirection dynamique non inlinable.
Pourquoi utiliser la structure HAMT plutôt qu’une std::unordered_map classique ?
La structure std::unordered_map subit des opérations de rehash global lors des redimensionnements, créant des pics de latence imprévisibles. Le HAMT (Hash Array Mapped Trie) évolue localement sans rehash global, garantissant ainsi une latence d’insertion extrêmement stable, indispensable pour les systèmes temps réel.
En quoi consiste l’optimisation guidée par le profilage (PGO) en C++ ?
Le PGO (Profile-Guided Optimization) est une technique où le compilateur utilise des données d’exécution réelles pour réorganiser le code assembleur. Il permet d’optimiser la disposition des branches conditionnelles et l’inlining des fonctions sur les chemins de code les plus fréquemment exécutés.
Comment le Pôle EXCELLENCE MARGO accompagne-t-il la montée en compétences en C++ ?
Le Pôle EXCELLENCE MARGO organise des Learning Expeditions sur des événements mondiaux comme la CppCon, finance au moins une formation certifiante par an et dispense des centaines de coachings par les pairs. Cela permet à nos ingénieurs de rester à la pointe des technologies critiques pour nos clients Grands Comptes.